基本的API
- 测试分词器api
method:post
url:http://localhost:9200/_analyze
body:
1 | { |
- 新建索引api
method:put
url:http://localhost:9200/student
body:
1 | { |
url中的student即为索引名,新建其他索引更换即可,并且此api可以根据put、delete,get达到新增、删除和查看的效果
- 查看全部索引
method:get
url:http://localhost:9200/_cat/indices - 为索引添加mapping
method:put
url:http://localhost:9200/student
body:
1 | { |
url中的student即为索引名,为其他索引创建mapping更换即可,此api可以根据put、get达到新增、和查看的效果
- 添加数据
method:post
url:http://localhost:9200/student/_doc/1?op_type=create
body:
1 | { |
url中的student为索引名,_doc为默认类型,elasticsearch7已经移除索引类型(type)概念,不再支持指定索引类型,默认索引类型是_doc,1是id,也可以不写,如果请求方式为put,则必须写,op_type=create的作用是当url中的id已存在的时候,会报错,如果不写op_type=create,而id又已经存在,则会更新
- 条件查询(四种查询模式:精确词查询、匹配查询、多条件查询、复合查询、聚合查询,分别对应 “term”、”match”、”multi_match”、”bool”、”aggs”)
method:get
url:http://localhost:9200/student/_search- 匹配查询
body:
- 匹配查询
1 | { |
2. 多条件查询
body:
1 | {"query":{"multi_match":{"query":"篮球","fields":["desc","name"]}}} |
query为查询条件,fields为查询字段,多条件查询命中一条就可以查出来,类似于or
3. 复合查询
body:
1 | { |
bool把各种其它查询通过 must(与)、must_not(非,不计算分数)、should(或)、filter (与、但不会计算分数)的方式进行组合,像这个例子中,只会匹配desc中有篮球并且有音乐的记录,但是如果should中的条件满足一条的话,会提高_source,也可以说提高分数,如果两条都满足,分数可以提高更多。must、should满足条件都会提高分数。与must同时存在时,should的作用就是将感兴趣的信息放在前面。特别注意,json格式不能同时存在两个match,只有最后一个会生效,故相同的查询方式只能放在数组中
4. 聚合查询
body:
1 | { |
这里根据procutid分组并且对age求和
桶的分组方式
Date Histogram Aggregation:根据日期阶梯分组,例如给定阶梯为周,会自动每周分为一组
Histogram Aggregation:根据数值阶梯分组,与日期类似
Terms Aggregation:根据词条内容分组,词条内容完全匹配的为一组
Range Aggregation:数值和日期的范围分组,指定开始和结束,然后按段分组
度量
度量类似mysql的avg,max等函数,用来求分组内平均值,最大值等。
比较常用的一些度量聚合方式:
Avg Aggregation:求平均值
Max Aggregation:求最大值
Min Aggregation:求最小值
Percentiles Aggregation:求百分比
Stats Aggregation:同时返回avg、max、min、sum、count等
Sum Aggregation:求和
Top hits Aggregation:求前几
Value Count Aggregation:求总数
列的类型
- 核心数据类型:
- string字符串:
- text:文本类型(分词);
- keyword:关键字类型(不分词);
- numeric-数值类型:
- long, integer, short, byte, double, float, half_float, scaled_float
- date-日期类型(存储自unix纪元以来的毫秒数);
- date_nanos:日期纳秒类型(存储自unix纪元以来的纳秒数);
- boolean-布尔类型;
- binary-二进制类型;
- range-范围类型:
- integer_range, float_range, long_range, double_range, date_range
- string字符串:
- 复杂数据类型
- object:对象类型;存储单个json对象;
- nested:嵌套类型;存储json对象数组;
- 数组类型(字段数组类型)
- 数组不需要专用的数据类型。一个字段默认可以包含0个或多个值。然而,数组中的所有值必须是同一种类型;
- 多字段类型:
- 根据不同目的以不同方式索引同一字段是有帮助的;
举例,字符串字段可以被映射为 text字段以便全文搜索,也可以映射为keword以便于排序或聚合。
- 根据不同目的以不同方式索引同一字段是有帮助的;
- 其他数据类型
- 如地理位置信息数据类型,ip数据类型等(没有罗列完全)
ElasticSearch数据结构
在了解写入流程前先来看下ES的结构是什么样子。这是网上介绍ES的一张图片,从中可以看出一个ES集群中有多个Server节点,每个Server节点中含有多个Index。
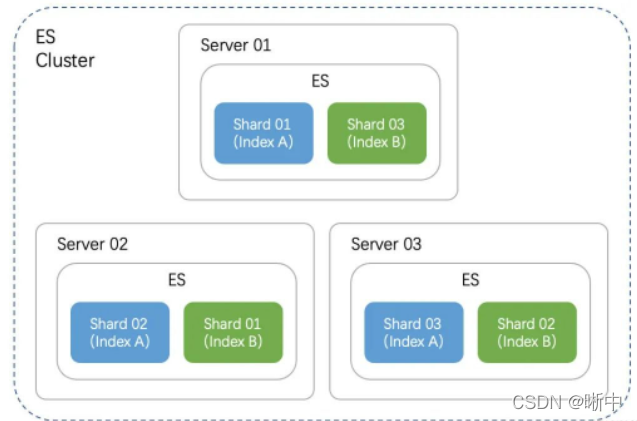
一个Index含有多个分片(shard),其中有一个 primary 主分片,负责写入,其他副本为 replica,不能写,只能同步 primary 的数据,但可以处理读请求。
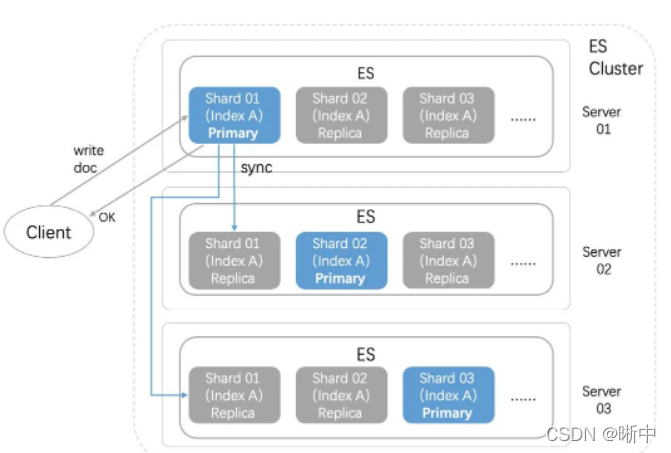
ES 收到写请求后,会将请求路由到index的主分片上。
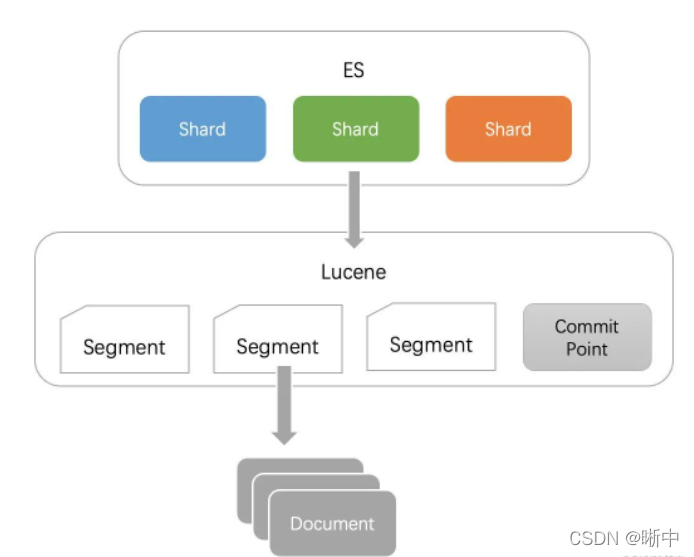
ES的底层是Lucene引擎,ES的每一个分片对应到底层实际上就是一个 Lucene Index,包含多个 segment 文件,和一个 commit point 文件。segment 文件存储的就是一个个的 Document,commit point 相当于一个索引文件,记录了都有哪些 segment 文件。
ElasticSearch读取流程
读阶段(query)
当客户端发出一个请求到服务端,收到请求的节点会成为协调节点,将请求发送到所有的分片上,分片收到请求,会在本地生成一个优先级队列,这个优先级队列的大小是from+size,故深度分页搜索不能用from+size,因为深度越大,这个优先级队列越大,性能就越低。举一个网上的列子:<font style="color:rgb(77, 77, 77);">假如有1万条数据记录了各种水果在全国各省市的销量,其中草莓的销量数据如下(三个颜色代表三个分片):</font>
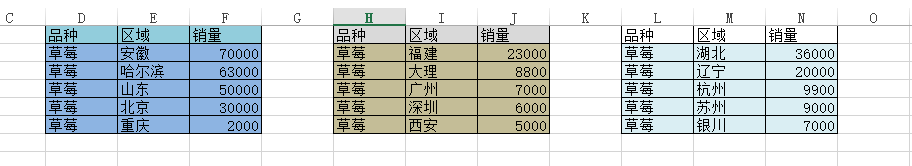
现在如果根据销量排序分页查询,假设from=2,size=2,那么每个分片将前四条数据放入优先级队列并返回给协调节点(只包括id和排序的字段)。我们假设一下如果不返回前条而是返回第三条和第四条数据的话,会怎么样,我们可以看出,我们最终想要的结果是深蓝色区域销量为50000和浅蓝色销量为36000的数据,如果每个分片只返回第三条和第四条数据的话,那么浅蓝色区域销量为36000的数据就无法被查出,数据的准备性就无法得到保证。协调节点收到所有分片的数据后,合并到一个全局的有序队列
取阶段(fetch)
   协调节点收到所有分片的数据后合并到一个有序队列,合并排序完后,查出自己需要的数据,然后根据id像分片查询完整文档。

   一般情况,都是query then fetch,即先读后取,但也可以query and fetch,即在query的时候直接返回完整文档,而不是只返回id和排序字段,这种方式查询速度很快,因为少了fetch的第二次查询,少了一次网络传输,但是如果查询数据量特别大的话,query and fetch的方式可能并不可取,因为在query阶段返回的数据可能是好几倍
ElasticSearch写入流程
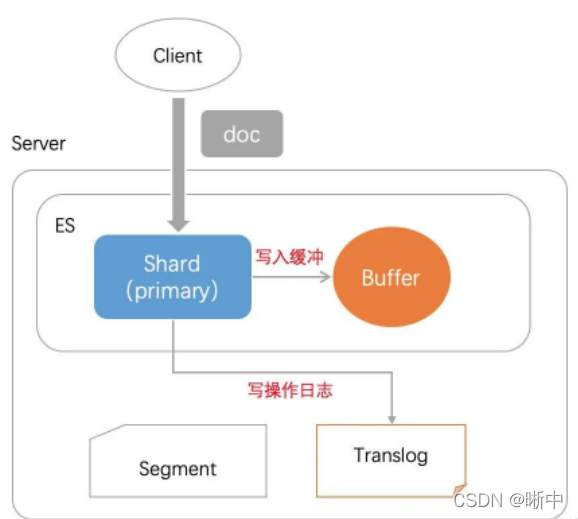
   从上图可以看出客户端写入请求进入ES后,首先会写入内存Buffer中,同时写入Translog日志,内存Buffer读写速度快,但因为不能持久化,所以并不安全,容易出现数据丢失,所以同时写入Tranlog日志,Tranlog日志只是做日志追加,所以写入快,并且稳定,如果系统出现宕机,重启后可以通过Tranlog日志恢复。

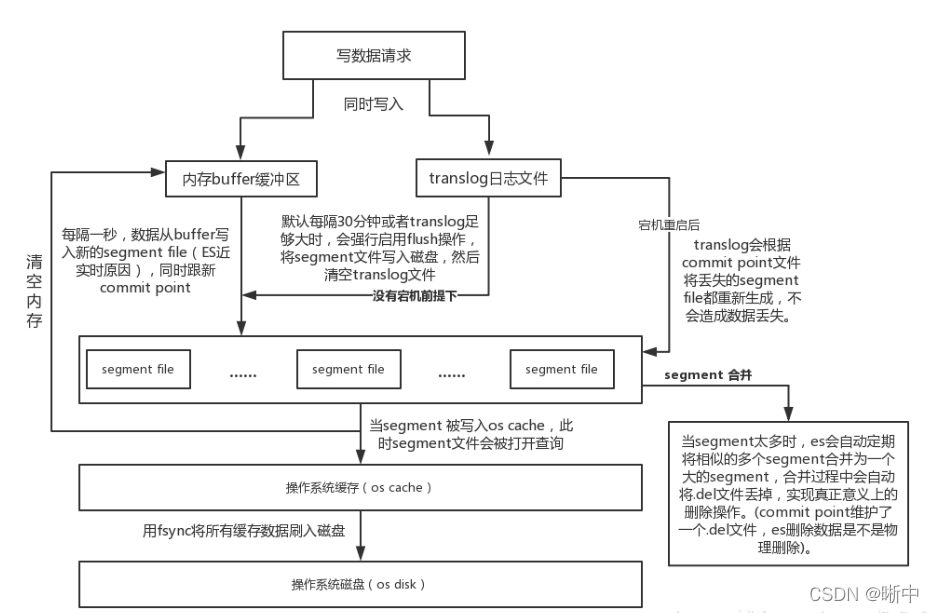
   ES每隔一秒就会执行一次refresh,创建一个Segment,并将Buffer内存写入Segment,ES 有一个后台程序,用于 merge 合并这些 segment 文件,把小 segment 整合到一个大的 segment 中,并修改 commit point 的 segment 记录。merge 过程还会清理被删除的数据。es 接收到删数据请求时,不会真的到 segment 中把数据删了,而是把要删除的数据写到 ‘.del’ 文件中,在读操作时,会根据这个文件进行过滤。merge 合并时才真正删除,合并后的 segment 中就没有已经删除的数据了。 进入 segment 的数据就进入了 Lucene,建立好了倒排索引,可以被搜索到,所以写入的数据最多只有一秒无法被搜索到。

   当数据写入Segment时,数据并没有真正落盘,因为系统本身还有一层缓存,这是系统自带的优化方法,<font style="color:rgb(77, 77, 77);">ES每隔5秒会异步执行一次fsync操作,将系统缓存强制写到真实的硬盘上</font>。

   当Translog日志大小达到阈值或者时间超过30分钟,就会触发flush操作。

         1、执行 refresh 操作。
2、把这次提交动作之前所有没有落盘的 segment 强制fsync,确保写入物理文件。
3、创建一个提交点,记录这次提交对应的所有 segment,写入 commit point 文件。
4、清空 Translog,因为 Segment 都已经踏实落地了,之前的 Translog 就不需要了。
ElasticSearch设置密码
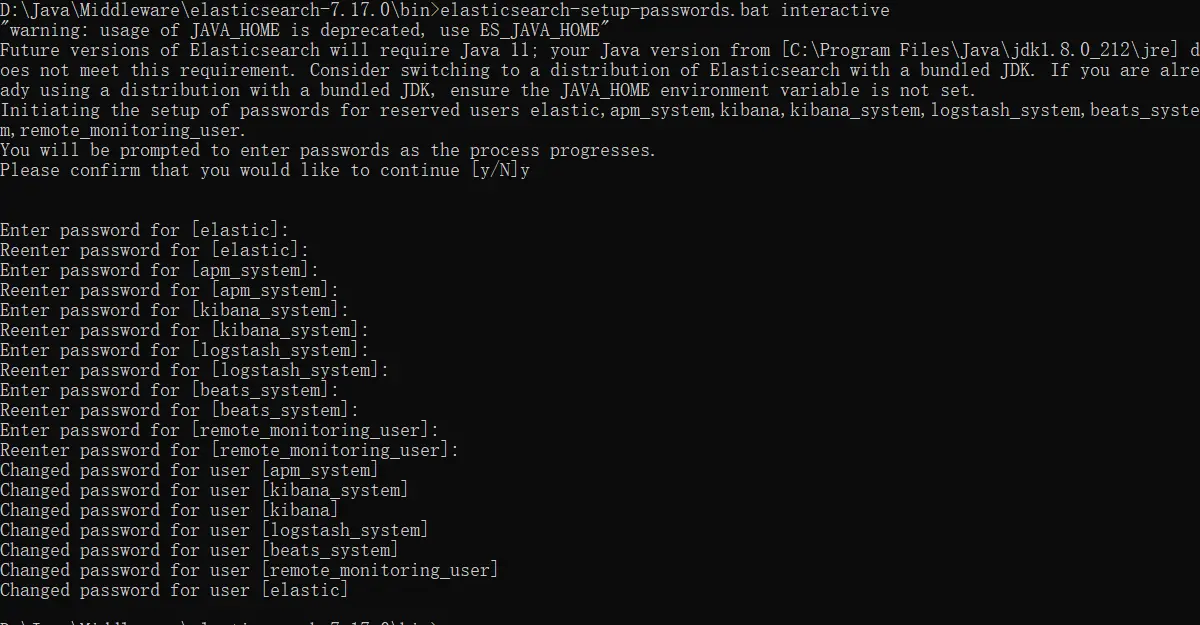
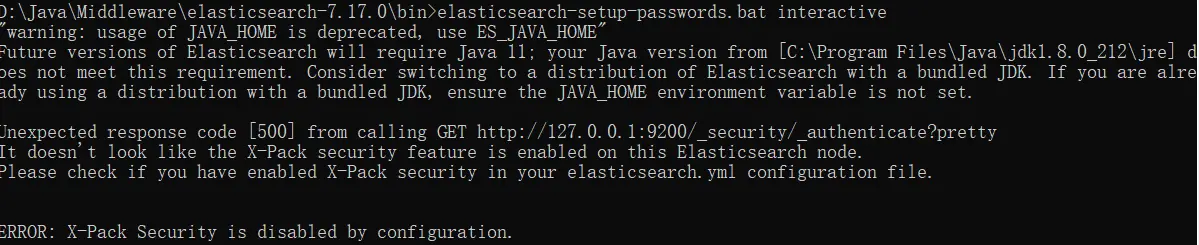
- 打开bin目录下的elasticsearch-setup-passwords.bat interactive

- 发现需要配置xpack,配置config目录下的elasticsearch.yml
1 | http.cors.enabled: true |
- 重启完elasticsearch,重复第一步并输入密码(账号是默认的)
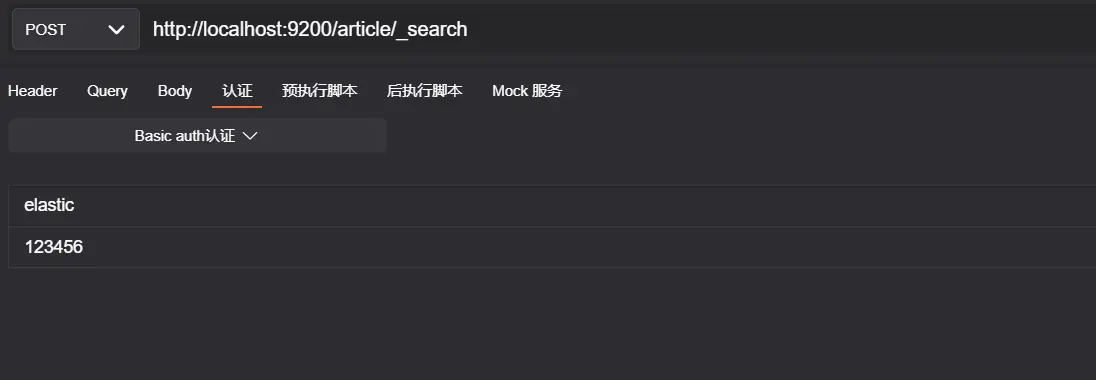
- 访问api时要加入账号密码,否则报错