Elasticsearch集群搭建配置
为每个节点添加以下配置,有些配置根据不通的节点做不同的配置
1 | #集群名称 |
为集群添加权限配置
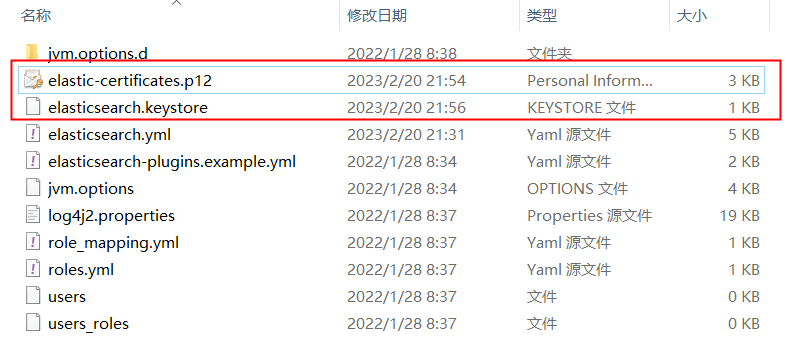
- 生成证书:在elasticsearch目录下执行以下命令在config目录下生成一个证书,执行这个命令时需要设置一个密码,下一步操作中需要用到这个密码
1 | bin\elasticsearch-certutil ca -out config\elastic-certificates.p12 |
- 将创建证书是设置的密码加入到Elasticsearch keystore中:在elasticsearch\bin目录下分别执行下面两条语句,密码输入刚才设置的密码
1 | elasticsearch-keystore add xpack.security.transport.ssl.keystore.secure_password |
将config目录下证书以及密码两个文件拷贝到其他节点的config目录下

在所有节点中加入以下配置
1 | http.cors.enabled: true |
- 启动所有节点,设置密码,在ealsticsearch\bin目录下执行以下文件,这个命令中需要给四个用户设置密码,建议设成一样的
1 | elasticsearch-setup-passwords interactive |
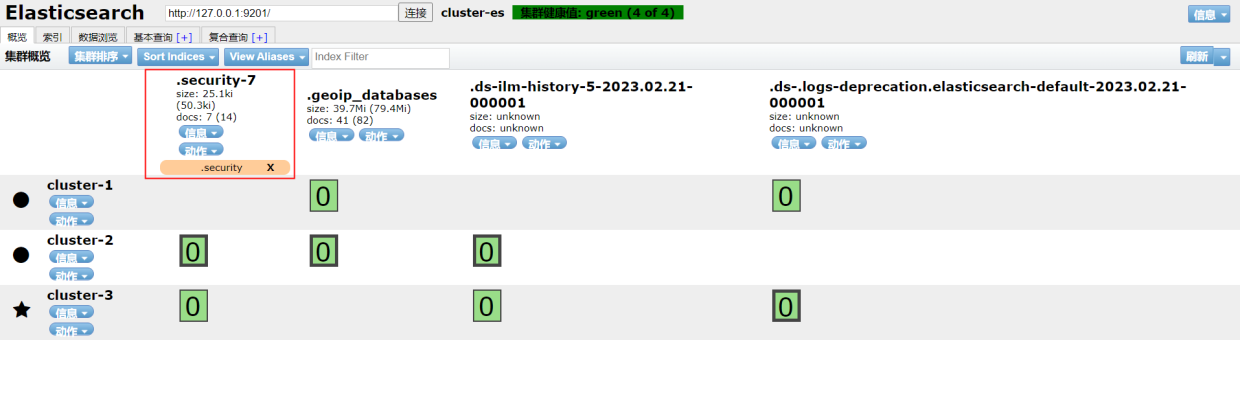
- 下面这个索引千万不能删(别名也不能删),是用来管理密码的
- ES集群需要启动半数才有效,不启动半数节点,输入账号密码也无法使用
ElasticSearch选主算法
7.x以前采用bully
7.x之后采用raft
raft算法
- term
term是raft全局维护的任期,一个任期只会有一个Leader,全局维护代表正常运行的情况下所有节点的term应该是一致的 - 角色,raft定义了三类角色
- Leader:主节点,负责消息写入
- Follower:负责消息读负载,写请求会重定向到Leader,接受Leader日志同步
- Candidate:Follower于Leader的中间角色
选主过程
- 每个节点有一个election timeout(表示未接受到Leader心跳的时间,150ms~300ms的一个随机数,避免多个节点同时发起选举),当一个节点超过election timeout没有收到Leader的心跳时就会将自己转为Candidate(集群初始化也是如此),将term加1,并向自己投一票,然后向其他人发出RequestVote RPC(让大家投他),有一个原则,统一任期的选举阶段,每个节点只有一票,遵从先到先得原则
- 如果该节点收到半数的投票,将自己转为Leader,并发送心跳,其他Follower收到心跳后,重置election timeout,达到阻止Follower发起选举的效果。如果因为其他节点term比自己大而遭到了拒绝,就会转为Follower,并重置election timeout。这里需要强调一下,在任何时候,不管是Leader或者Candidate,只要收到term比自己大的消息,就会转为Follower。
- raft选举过程可以保证选举出来的Leader的日志比大部分节点新,而且加上raft的日志同步机制,可以保证Leader的日志比全部已提交的日志更新或者一样(包括前一个Leader),因为日志的提交需要满足日志已经被复制到超过半数节点,所以如果一个节点被过半数的节点选举,证明它的日志一定等于或者新于已提交的日志。
日志同步
Leader选出后,就开始接收客户端的请求。Leader把请求作为日志条目(Log entries)加入到它的日志中,然后并行的向其他服务器发起 AppendEntries RPC 复制日志条目。当这条日志被复制到大多数服务器上,Leader将这条日志应用到它的状态机并向客户端返回执行结果。某些Followers可能没有成功的复制日志,Leader会无限的重试 AppendEntries RPC直到所有的Followers最终存储了所有的日志条目。这里可以看出raft写操作并不是强一致性。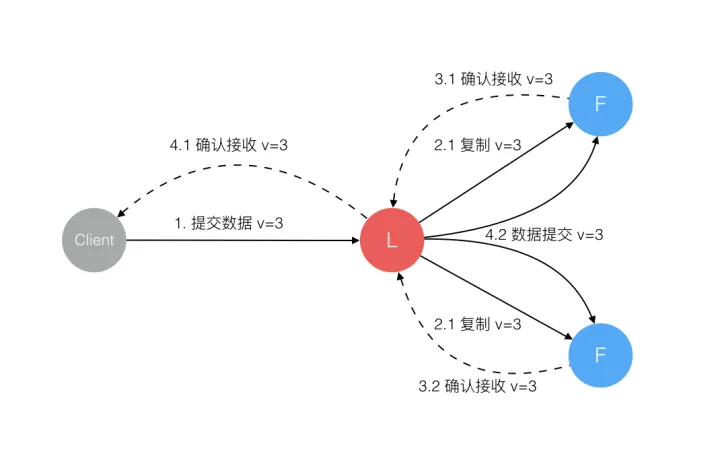
日志由有序编号(log index)的日志条目组成。每个日志条目包含它被创建时的任期号(term),和用于状态机执行的命令。如果一个日志条目被复制到大多数服务器上,就被认为可以提交(commit)了。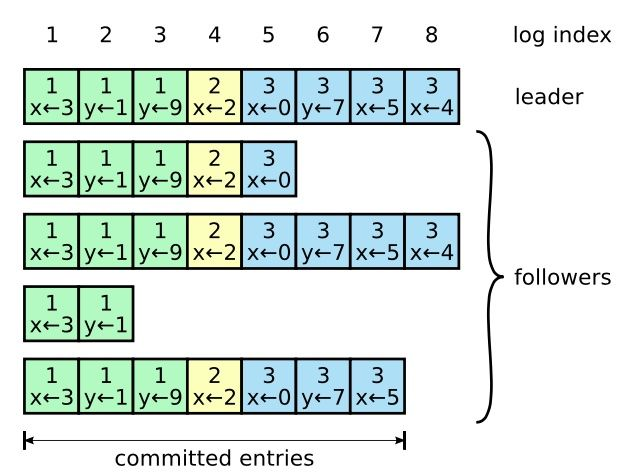
Raft日志同步保证如下两点
- 如果不同日志中的两个条目有着相同的索引和任期号,则它们所存储的命令是相同的。
- 如果不同日志中的两个条目有着相同的索引和任期号,则它们之前的所有条目都是完全一样的。
第一条是因为每个任期内,Leader在指定的index long处,最多创建一个日志条目,并且该条目的位置不会变。
第二条是因为 AppendEntries 的一个简单的一致性检查。leader通过发送日志复制RPC的一致性检查找到follower与自己相同日志项的最大索引值,然后,leader强制复制follower更新覆盖的不一致日志项。
leader给follower发送日志复制信息中带着(PrevLogTerm, PrevLogEntry)。PrevLogEntry表示当前复制日志项前一条的索引值。PrevLogTerm表示当前要复制的日志项前面一条的任期编号。
比如,下图中leader将索引值为8的日志项发送给follower,那么PrevLogTerm值为4,PrevLogEntry为7。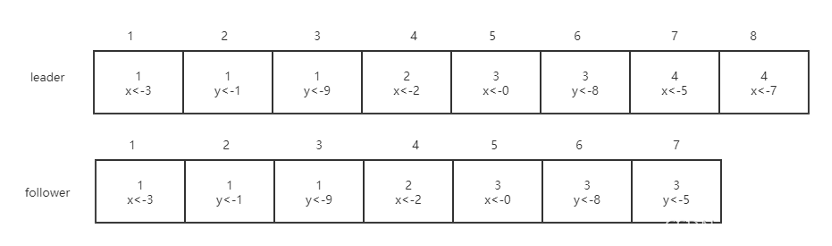
- leader通过日志复制RPC消息发送当前日志项到follower。比如上图PrevLogEntry值为7,PrevLogTerm值为4。
- 如果follower在它的日志中,找不到与PrevLogEntry为7,PrecvLogTerm值为4的日志项表示它和leader的日志文件不一致了,那么follower拒绝接受新的日志项,并返回失败信息给leader。
- leader递减要复制的日志项的索引值,并发送日志项到follower,既值为(6,3)的日志项。
- 如果follower在它的日志中找到了PrevLogEntry值为6,PrevLogTerm值为3的日志项,日志复制RPC返回成功,这样leader就知道在PrevLogEntry值为6,PrevLogTerm值为3的位置,follower和leader的日志项相同。
- leader发送日志复制RPC消息给follower,follower复制并覆盖该索引之后的日志项,最终实现了集群各节点日志的一致。
- 安全性
Raft增加了如下两条限制以保证安全性:
- 拥有最新的已提交的log entry的Follower才有资格成为Leader。
这个保证是在RequestVote RPC中做的,Candidate在发送RequestVote RPC时,要带上自己的最后一条日志的term和log index,其他节点收到消息时,如果发现自己的日志比请求中携带的更新,则拒绝投票。日志比较的原则是,如果本地的最后一条log entry的term更大,则term大的更新,如果term一样大,则log index更大的更新。 - Leader只能推进commit index来提交当前term的已经复制到大多数服务器上的日志,旧term日志的提交要等到提交当前term的日志来间接提交(log index 小于 commit index的日志被间接提交)。这个较为复杂,可查看参考文章第四节
ElasticSearch7.X之后集群算法
选举过程
- 节点的初始化状态为Candidate;
- 启动选举任务,向探测到的集群中其他节点发送PRE_VOTE投票请求,请求中会携带节点的Term信息;
- 其他节点收到PRE_VOTE投票请求后,对请求进行处理:
(1)更新自己收到过的最大的Term
如果请求中的Term比自己的Term大并且当前节点是Leader节点,意味着当前的Leader可能已经过期,其他节点已经开始竞选Leader,所以此时当前节点需要放弃Leader的身份,重新发起选举。
(2)根据当前节点记录的Leader信息决定是否投票给发起者,然后向发起者返回投票响应信息:
-  如果当前节点记录的集群Leader为空,同意投票给发起者。
-  如果当前节点记录的集群Leader不为空,但是与本次发起的节点一致,同样同意投票。
-  如果当前节点记录的集群Leader为空,但是与本次发起的节点不同,拒绝投票给发起者。
- 发起者收到其他节点对PRE_VOTE投票请求的响应,判断是否得到了大多数投票,如果是进入下一步;
- 发起者向集群中的节点发送StartJoin请求,邀请节点加入集群,发送StartJoin请求的时候会将Term增加1,但是发起者的Term暂不更新,这与Raft协议在发起选举的时候就对Term增加的操作不一样;
- 其他节点收到StartJoin请求,更新自己的Term信息,处理完毕后向发起者发送JOIN请求,JOIN请求中携带了节点的Term信息;
收到StartJoin请求时,只要请求中的Term比当前节点的Term大,当前节点都会同意为发起者进行投票,这里也与Raft协议规定的每个任期内只能为一个节点进行投票不一致。
既然节点可以多次进行投票,那么就有可能产生多个Leader,对于这种情况,Elasticsearch会选择最后那个选举成功的节点成为Leader。
- 发起者收到其他节点发送的JOIN请求后,会统计收到的JOIN请求个数,如果达到了大多数投票,即可成为Leader;
发起者收到JOIN请求时也会校验自己的Term是否比JOIN请求中的Term大,在第5步中发起者并未更新自己的Term,所以首次收到JOIN请求后,Term信息会小于JOIN请求中的Term,这里发起者会模拟一个JOIN请求给自己,也就是自己为自己投一票。
- 发起者成为Leader;文章来源站点
日志同步
ElasticSearch的数据并不是基于节点间的主副本,而是基于分片间的主副本,<font style="color:rgb(61, 70, 77);">默认情况下当大多数副本都同步完成时,就返回存储完成的通知。这个可以通过 consistency 参数配置,all 表示必须所有的 副本都同步完成才返回存储完成的通知,one 表示只要主分片同步完成就返回存储完成的通知(检索结果可能会被还未同步的副本处理,造成未检索到),默认值是 quornum</font>。
ES写入失败可以分为主分片写入失败和副本分片写入失败:
- 主分片写入失败:主分片写入失败时,即判定这次写入请求整体失败,并且一个副本分片将成为主分片
- 副本分片写入失败:主分片在将数据同步给副本分片时,如果失败了,仍然会返回写入成功,但是将同步失败的副本分片置为不可读,以保证数据的一致性,等该副本分片同步完成后,重新置为可读