介绍间隙锁的一篇博客
我们先准备一张测试表
1 | CREATE TABLE `test` ( |
id为主键;
a为普通索引;
b为普通列;
再准备一些数据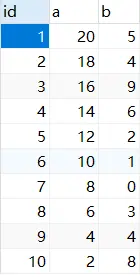
先看下目前a索引上的数据(不是真实的索引结构)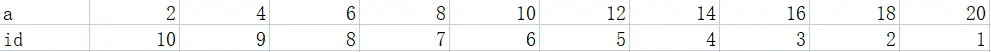
普通索引等值查询
sql语句
1 | begin; |
//解释:进行查询并加排他锁
运行下面语句查看加锁信息(所有的锁都是加在索引上的,这一点很重要)
1 | select * from performance_schema.data_locks; |
结果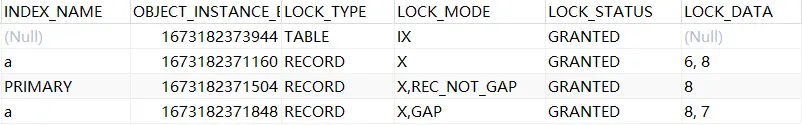
//这是我认为比较重要的信息,没有将所有内容截取下来
LOCK_DATA代表锁住的索引,where a = 6这条数据走的是a索引的(6,8)这条索引,所以a索引的(6,8)被锁住了,第三行的(8)代表这条主键索引被锁住了,可能和回表的机制有关系,第四行是本次的重点:间隙锁
测试:
1 | update test set b = 7 where a = 6; |

相当于修改该索引的值,由于写锁的存在,所以修改失败
1 | update test set a = 3 where id = 9; //成功 |
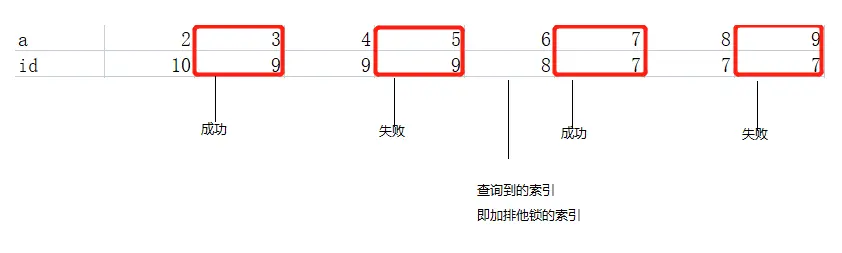
可以得出结论,查询到的索引和的前一个索引以及后一个索引之间不允许插入新的索引(要明白和插入数据的区别)
//注:这里我们直接修改原始的id(id为9和id为7)的数据,这里只考虑顺序性,与具体的id无关*
这里需要强调一下,间隙锁是指索引之间的范围,不具体指哪条索引,间隙锁没有锁住任何一条索引,它锁住的是一个范围,所以查询到的索引的前后的索引是可以改变的,锁住的范围为((4,9),(8,7)),即该范围内的索引不能发生变化,这里可以发现,两边都是开区间,所以(4,9)和(8,7)作为边缘值,是可以发生变化的
1 | delete from test where id = 7; //执行成功 |
索引结构变为
同时间隙锁的范围也发生变化了,范围变成了((2,10),(10,6))
普通索引等值查询(存在多条语句,即有多个索引)
先改变一下数据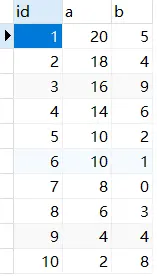
sql语句
1 | begin; |
加锁的情况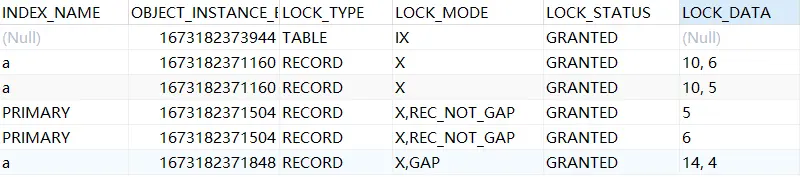
和只查询一个条件的时候没有区别,所以查询出来的索引都加上了排它锁,最后一个索引的后一个索引加上了gap锁(间隙锁),锁住的范围为((8,7),(14,4))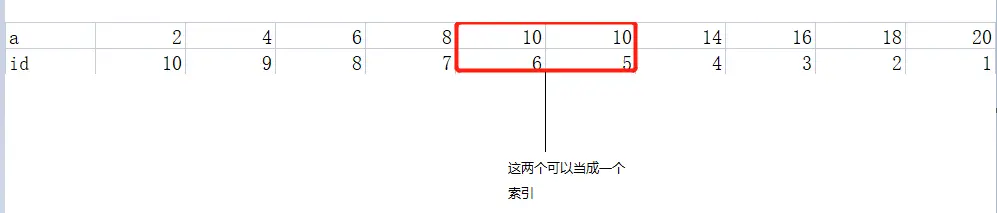
普通索引等值查询(查询条件不存在)
sql语句
1 | begin; |
加锁情况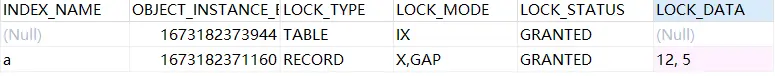
那么间隙锁的范围: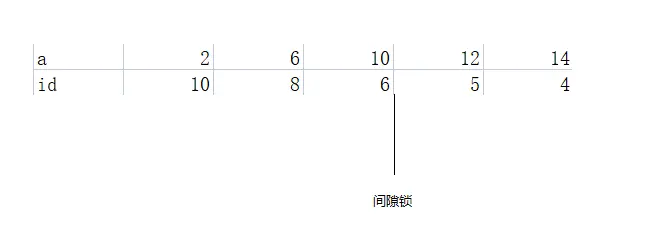
加锁范围为((10,6),(12,5))
普通索引范围查询
SQL语句
1 | begin; |
加锁信息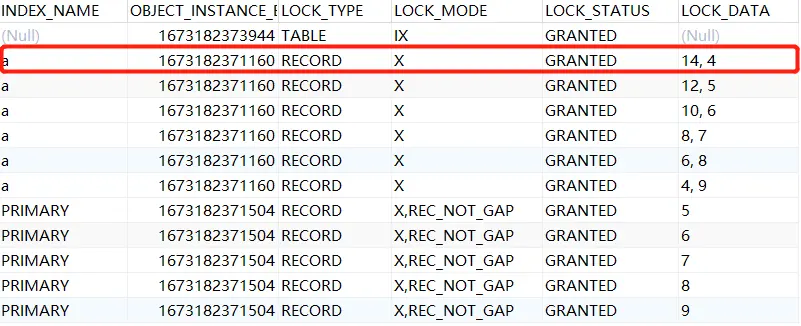
不难看出,与上面的区别在于索引(14,4)的锁类型从(X,GAP)变成了(X),意味着所以(14,4)变成了排它锁,则锁住的范围是((2,10),(14,4)],由于查询到的最后一个索引的下一个索引,从gap变成排他锁,所以右边变成了闭区间,成了临键锁,需要注意,包括’>’和’<’等操作也是一样的
普通索引范围查询(查询不到索引)
数据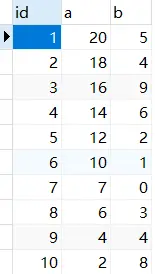
SQL语句
1 | begin; |
锁信息
可以看出,和等值查询(查询不到索引)的区别在于,范围查询会将下一个索引加上排它锁,锁住的范围为((10,6),(12,5)]
总结
我们不难发现,范围查询和等值查询的区别在于,范围查询会将查询到的最后一个索引的下一个索引也加上排他锁,导致整个间隙锁的范围向右加了一个索引的范围,而整个范围的左右没办法做新增索引的操作的,其实不能做新增索引操作的是范围是,所有加上排它锁的索引的左右
记录锁就是查询到的记录上的锁,间隙锁就是加入排它锁索引的左右,临键锁就是记录锁和间隙锁的集合
主键(唯一索引)
等值查询
sql语句
1 | begin; |
加锁信息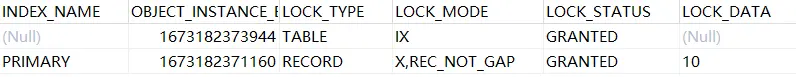
范围查询
sql语句
1 | begin; |
加锁信息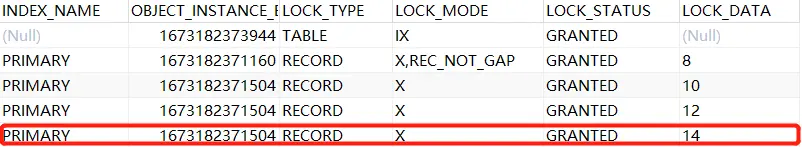
//画红线的地方是一个bug,8.0.22之后,将无法访问到不满足条件的第一个值
总结
不难发现,主键(唯一索引)与普通索引的区别在于最左边,失去了间隙锁的功能,等值查询例子中,id = 10的索引的左右都可以新增索引,因为(X)变成了(X,REC_NOT_GAP),而且失去了下一个索引的(X,GAP),而在范围查询中,8的左边不能新增索引,即最左边索引的(X)退化成了(X,REC_NOT_GAP),同时失去了最右边的间隙锁,可以认为相比较之下,唯一索引失去了保护左右的能力
整体总结
个人觉得可以这么认为,(X)拥有保护自己和左边的作用,(X,REC_NOT_GAP)只能保护自己,不能保护左边,(X,GAP)可以保护左边,但不能保护自己,而且它是伴随着(X)出现的,所以持有(X,GAP)的索引可以发生变化(比如持有(X,GAP)的索引被删除,则接替他位置的持有(X,GAP)),按照这个原则,可以很好的解释上面的情况,不过这是我自己根据实验现象得出的,不一定准确,可能有其他的影响因素,(X)就是临键锁,(X,REC_NOT_GAP)是记录锁,(X,GAP)是间隙锁,可以理解为后两者都是前者退化而来
临键锁的前开后闭
临键锁的前开后闭是指查询的索引的前一个索引是开,后一个是闭
例如:where a >10 and a < 12(假设10的索引和12的索引存在),那么临键锁就是(10,12]
**两个原则以及两个优化
原则1:加锁的基本单位是 next-key lock。next-key lock 是前开后闭区间。
原则2:查找过程中访问到的对象才会加锁。
优化1:索引上的等值查询,给唯一索引加锁的时候,next-key lock 退化为行锁。
优化2:索引上的等值查询,向右遍历时且最后一个值不满足等值条件的时候,next-key lock 退化为间隙锁。
一个 bug:唯一索引上的范围查询会访问到不满足条件的第一个值为止。 8.0.22之后已修复,故唯一索引上的范围查询,第一个满足条件和最后一个满足条件的索引会退化为行锁
**关于两个优化
- 我们可以认为只需要考虑等值查询的情况,非等值查询一律按照普通的next-key处理,查询到的索引和向右遍历最后一个不满足等值条件的索引会被加上行锁,而当等值查询时,向右遍历最后一个不满足等值条件的索引的行锁会消失,并且当走的是唯一索引的时候,间隙锁也会消失,只剩行锁
- 我们知道,在查询操作时,索引是向右遍历的,当遇到第一个不满足条件的索引时,结束查询,并未该索引加上行锁,但是如果使等值查询,该锁便不会加行锁了,并且如果该索引是唯一索引时,两边的间隙锁也会消失