官网
RabbitMQ: One broker to queue them all | RabbitMQ
GitHub - rabbitmq/rabbitmq-website: RabbitMQ website
消息队列的意义
- 解耦:如果使用传统的服务调用,生产者需要通过调用消费者的接口达到将数据传送给消费者的目的,但是如果当一台消费者不需要该数据了或者有另外一台机器也需要该数据,则需要修改生产者内部代码,耦合性太强,如果使用消息队列,生产者只需要将数据放在队列中,而无需关心谁来读取这条数据
- 异步:如果服务A完成某个业务功能需要通过陆续调用服务B,C,D的接口才能完成,而服务A不想因为调用服务B,C,D的接口耽误下面的业务的进行,这个时候可以使用消息队列,将消息放入队列中,然后继续往下执行代码
- 削峰填谷:如果某一时段服务A请求量巨大可能会导致服务A奔溃,这种情况可以先将请求放入队列中而不需要让服务A一次性处理所有请求
RabbitMQ安装
rabbitmq安装首先需要安装erlang,而且是有版本要求的,可以通过https://www.rabbitmq.com/docs/which-erlang查看具体版本对应关系
安装erlang
- 进入https://erlang.org/download/找到对应的系统和版本下载安装
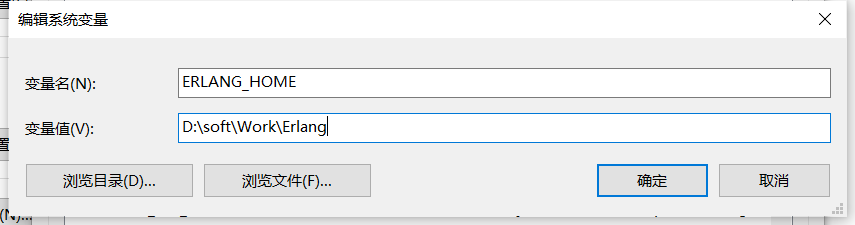
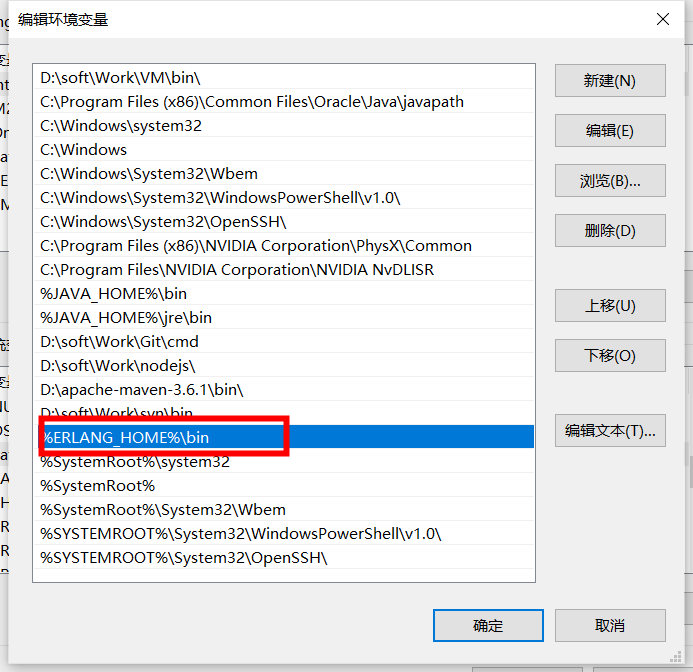
- 配置环境变量

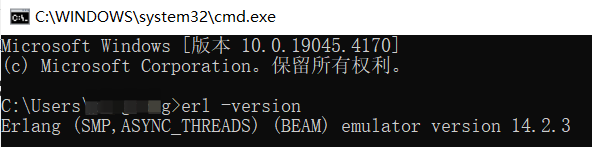
- 测试
安装RabbitMQ
- 进入https://github.com/rabbitmq/rabbitmq-server/releases找到合适的系统和版本下载安装
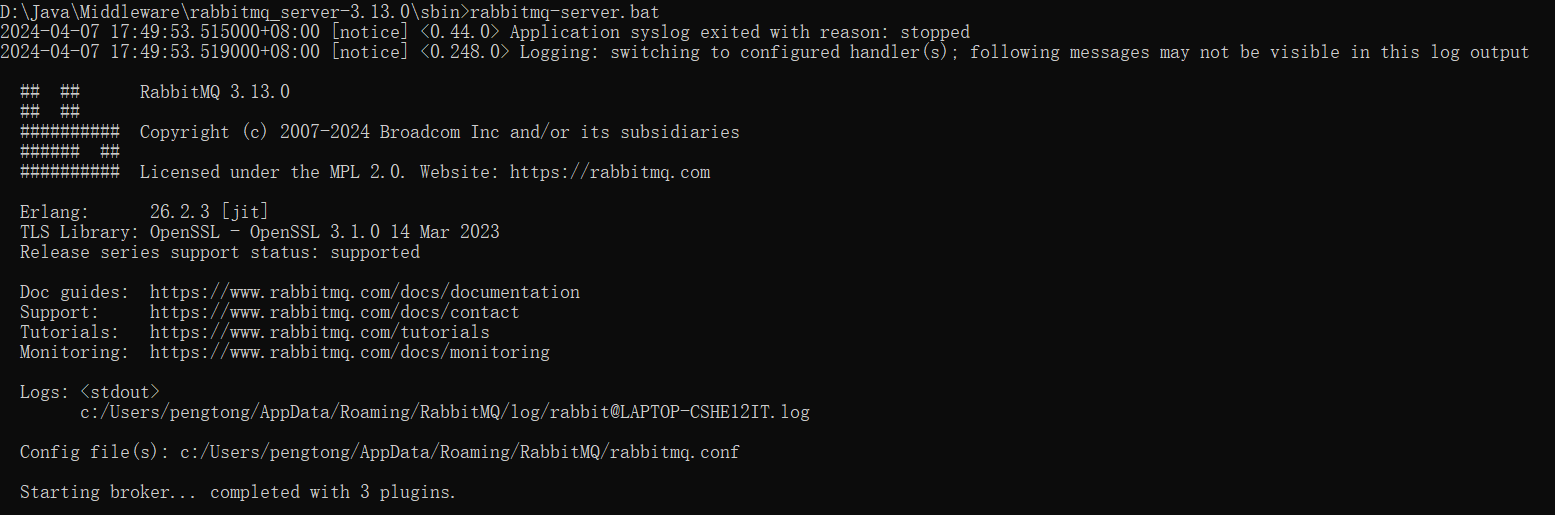
- 启动rabbitmq
RabbitMQ配置
rabbitmq配置文件的地址有点特殊,不像其他中间件,rabbitmq的配置文件是根据系统环境变量确定的,在未配置的情况下使用默认配置rabbitmq配置默认地址,rabbitmq配置可选项以及默认配置参考rabbitmq配置可选项以及默认配置
RabbitMQ可视化插件
1. 列出可用插件
首先,你可以查看已安装但未启用以及已启用的所有插件。在命令行中,进入RabbitMQ的sbin目录(例如,cd /usr/sbin 或者根据你的安装路径),然后运行:
1 | rabbitmq-plugins list |
这将列出所有插件的状态,标记为 [E*] 的是已启用的插件,而 [ ] 或其他表示未启用。
2. 启用插件
要启用一个插件,使用rabbitmq-plugins enable命令后面跟插件的名字。要启用RabbitMQ Management插件(提供了Web管理界面),可以运行:
1 | rabbitmq-plugins enable rabbitmq_management |
3. 重启RabbitMQ服务
可视化插件在启用后需要重启RabbitMQ服务才能生效。访问默认为地址为<ip>:15672
RabbitMQ结构
对于RabbitMQ而言,最关键的东西就是交换机,路由和队列,交换机负责接收生产者的消息,路由负责绑定交换机和队列,队列负责存储消息等待消费者消费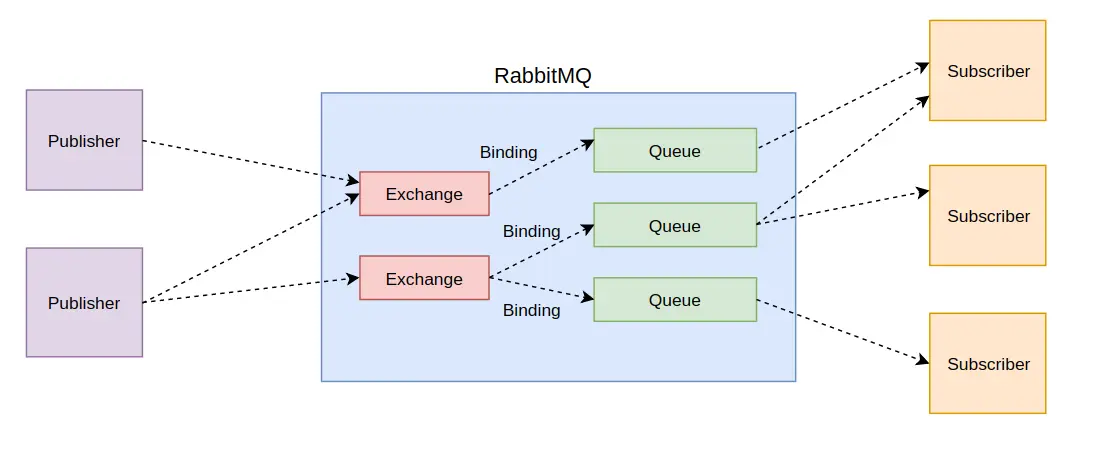
消息顺序性
从RabbitMQ的结构来看,消息从生产者到消费者的过程中,生产者只能将消息提交给一个Exchange,Exchange可以根据路由将消息发送给一个或多个Queue,Queue只能将消息推送给一个消费者。所以想要实现RabbitMQ消息的顺序性,可以根据全局顺序性和局部顺序性做出不同的调整,这里默认生产者和消费者同步推送和同步消费,异步推送或者异步消费必然会影响顺序性
- 全局顺序性:在全局顺序性的情况下,必须要保证每条消息都按照顺序传递,那么只能有一个生产者,一个队列,一个消费者
- 局部顺序性:在局部顺序性的情况下,即将消息分类别保证顺序性,则只需要保证同一类别的消息由同一个生产者推送,并且进入同一个队列,并且由同一个消费者消费即可
- 要保证同一类别的消息由同一个生产者推送,第一步很好实现
- 要保证同一类别的消息进入同一个队列,可以通过设置Exchange以及合适的路由键,控制同一类消息进入同一个队列
- 要保证同一类别的消息由同一个消费者消费,因为队列的一条消息只能推送给一个消费者,多个消费者会造成随机推送,所以对应的队列只能有一个消费者
消息持久化
消息持久配置
RabbitMQ持久化涉及到交换机持久化、队列持久化、消息持久化三个部分,RabbitMQ使用Mnesia数据库存储队列、交换机等元数据,消息由RabbitMQ本身负责持久化
- 交换机持久化:交换机持久化需要将交换机的durable属性配置为true,在spring-amqp中,可以在交换机构造函数中设置durable属性
1 | public TopicExchange(String name, boolean durable, boolean autoDelete) { |
- 队列持久化:队列持久化需要将队列的durable属性配置为true,在spring-amqp中,可以在队列构造函数中设置durable属性
1 | public Queue(String name, boolean durable) { |
- 消息持久化:消息持久化即在发布消息时,需要将消息的deliveryMode属性设置为2,在spring-amqp中,MessageProperties类的deliveryMode属性默认是2,即发送到消息如果不做特殊处理,是默认持久化的
1 | //这是MessageProperties中的一个静态代码块,用于设置deliveryMode和priority属性 |
1 | public static int toInt(MessageDeliveryMode mode) { |
消息存储文件
经典队列
以Windows为例,RabbitMQ经典队列消息持久化主要存在于“%RABBITMQ_MNESIA_DIR%\msg_stores\vhosts<vhosts-name>”下面
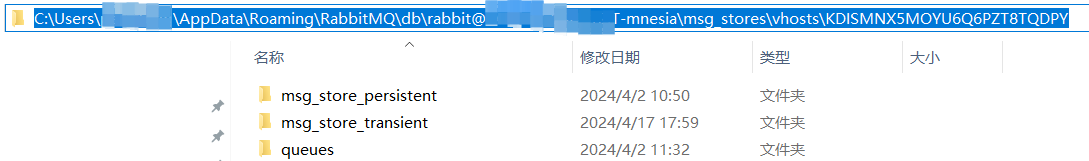
其中
- msg_store_persistent:存放rabbitmq持久化消息文件,文件名格式为“数字.rdq”,持久化消息在到达队列是写入磁盘,同时会在内存中保存一份备份,当内存紧张时,消息将会从内存中消除.存储到内存中主要目的是提高一定效率
- msg_store_transient:存放rabbitmq非持久化消息文件,文件名格式为“数字.rdq”,非持久化消息一般只存在内存中,当内存压力大时,将会进行刷盘操作,以缓解内存压力
- queues:存放每个队列的消息索引文件,文件名格式为“数字.idx”,自 RabbitMQ 3.5.0 版本起,小消息(内容、属性及 headers 总长度小于特定阈值,默认为 4096 字节)会直接存储在 idx 文件中,而非单独存放在消息存储中。这样可以减少一次磁盘写操作,提高性能。此行为可以通过配置项 queue_index_embed_msgs_below 控制。
当idx文件中记录的消息被消费时,会被标记,当idx文件记录的所有消息都被消费时,idx文件会被删除,虽然此时idx被删除了,但如果是持久化消息,msg_store_persistent中的rdq文件不会收到影响,即消息本身不会被删除
仲裁队列
以Windows为例,RabbitMQ经典队列消息持久化主要存在于
“%RABBITMQ_MNESIA_DIR%\quorum<vhosts-name>”下面,与经典队列不同,仲裁队列在存储路径上,不区分虚拟主机,但是如果两个虚拟机创建同一名称的仲裁队列,在路径表现上,名称是不一样的
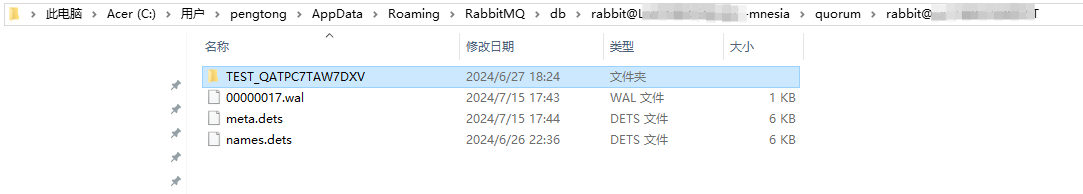
其中
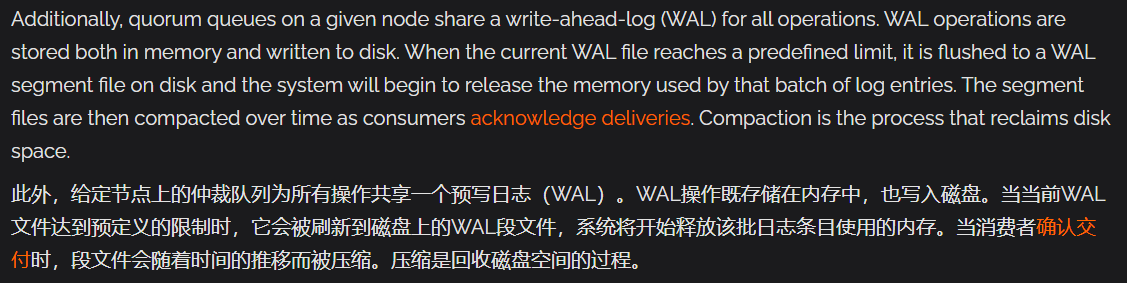
- wal文件,仲裁队列的预写文件,是所有队列共享的文件,它既刷入磁盘也存在于内存中,但是当大小达到阈值时,消息会被写入对应队列的段文件中用来释放内存,所以段文件不存在内存中,这里的阈值可以通过raft.wal_max_size_bytes配置控制,默认值是64MiB
- segment文件:上面提到的段文件,存放在每个队列对应的文件夹当中,名称是”数字.segment”,有消息条数据限制,超过限制后,在原先文件名加一生成一个新文件,这个限制可以通过raft.segment_max_entries控制,默认值是4096,最大不能超过65535
消息模式
- 工作模式:直接将消息投递到队列,这种方式是通过逻辑交换机实现的,逻辑交换机是RabbitMQ为每个新创建的队列自动绑定的一个特殊交换机。每个队列在创建时自动绑定到默认交换机上。这个绑定的Routing Key就是队列的名称。如果生产者发送消息时不指定Exchange(或者明确指定为默认交换机),并且提供了Routing Key,那么RabbitMQ会将这个Routing Key视为队列名,并尝试将消息直接发送到对应的队列中。
- 发布订阅模式:将一个消息投递到多个队列,进而实现将同一条消息投递到多个消费者,这种方式是通过扇形交换机实现的。扇形交换机会忽略路由键,将接收到的消息广播到与之绑定的所有队列。这种类型的交换机适用于发布/订阅模式,其中消息需要被多个消费者接收。
- 直连模式:可以通过指定routeKey将消息投递到特定的一个或多个队列,进而实现将同一条消息投递到多个消费者,这种方式是通过直连交换机实现的,它在扇形交换机的基础上多了一层选择
- 路由模式:在直连模式的基础上实现了更加的灵活的方式,routeKey支持使用通配符(*和#),允许更灵活的路由规则
消费模式
RabbitMQ的消费模式主要包括两种:推模式(Push)和拉模式(Pull)。
- 推模式(Push):在推模式中,RabbitMQ会主动将消息推送给消费者。这一过程是通过调用basic.Consume方法实现的。当消费者调用此方法时,它会订阅队列,此后RabbitMQ就会开始向消费者推送消息。推送的消息数量可以受到Basic.Qos(Quality of Service)设置的限制,用来控制消费者预取的消息数量,防止消费者处理能力不足时消息堆积。推模式简化了消息处理流程,适用于大多数需要高效实时处理消息的场景。在spring-amqp中通过channel.basicConsume方法
- 拉模式(Pull):拉模式则是消费者主动从RabbitMQ拉取消息的过程,通常通过调用basic.Get方法来实现。在拉模式下,消费者决定何时从队列中请求消息,每次请求通常只获取一条消息。尽管可以循环调用basic.Get来模拟持续接收消息的行为,但这并不推荐,因为它会显著降低RabbitMQ的性能。拉模式给予消费者更多的控制权,但在大多数场景下不如推模式高效。在spring-amqp中通过channel.basicGet方法
选择推还是拉模式主要取决于应用的需求:
- 推模式适用于需要实时处理消息且对消息处理有较高效率要求的应用场景,因为它可以减少消息处理的延迟。
- 拉模式适用于那些消费者需要更多控制权,比如按需处理消息,或者资源有限,希望在处理完一条消息后再获取下一条的场景。
在实际应用中,推模式更为常见,因为它能更好地利用消息队列的异步处理能力和提高系统的响应速度。然而,在某些特殊需求下,拉模式也能提供更加灵活的控制选项。
此外,在Kafka、RocketMQ、RabbitMQ中,只有RabbitMQ真正实现了推模式,RocketMQ的推模式实际上还是通过拉模式实现的,而Kafka没有推模式,这一点让RabbitMQ在低延迟方面有优势
消息过滤
RabbitMQ 提供了几种消息过滤机制来帮助消费者精确订阅他们所需要的数据。以下是一些主要的消息过滤方式:
- 基于路由键(Routing Key)的过滤: RabbitMQ 中的基本消息路由是通过交换机(Exchange)和路由键实现的。生产者发送消息到交换机时会指定一个路由键,而消费者通过队列与交换机绑定时也会指定一个或多个绑定键(Binding Key)。交换机会根据路由键和绑定键的精确匹配将消息路由到对应的队列。这意味着,消费者可以通过设置合适的绑定键来过滤掉不感兴趣的消息。
- 基于消息属性的过滤: RabbitMQ 支持消息属性(Message Properties),这些属性可以是发布消息时自定义的元数据。虽然RabbitMQ本身不直接提供基于消息属性的过滤,但可以通过插件或消费者逻辑来实现。例如,可以编写一个插件或消费者代码,检查消息的属性并据此决定是否接收处理消息。
- Topic Exchange 的模式匹配: 使用topic类型的交换机可以实现更复杂的基于模式的过滤。在这种模式下,绑定键和路由键可以包含通配符(和#),允许更灵活的匹配规则。例如,#.orange.可以匹配所有包含.orange.的消息,而lazy.#可以匹配所有以lazy.开头的消息。
- 消息选择器(Message Selectors): 虽然不是RabbitMQ原生支持的功能,但可以通过AMQP协议的消息选择器功能在消息消费时根据消息内容的属性进行过滤。不过,这种方式相比其他过滤机制来说效率较低,因为需要消费者逐一检查消息内容。
- 插件辅助过滤: 有时候,为了实现更高级的过滤逻辑,可以使用第三方插件,比如消息去重插件或其他自定义插件,这些插件可以提供额外的过滤功能。
在设计消息过滤策略时,需要平衡过滤的精确度和系统的性能,同时也要考虑易用性和可维护性。根据业务需求选择最合适的过滤方式是至关重要的。
消息丢失
消息丢失主要从生产者、MQ、消费者三者考虑消息丢失的情况
生产者解决消息丢失问题主要有两种方式
- 事务:生产者发送数据之前开启 RabbitMQ 事务channel.txSelect,然后发送消 息,如果消息没有成功被 RabbitMQ 接收到,那么生产者会收到异常报错,此时就可以回滚事务channel.txRollback,然后重试发送消息;如果收到了消息,那么可以提交事务channel.txCommit,类似我们数据库数据库事务机制。
- confirm模式:用于确认消息是否已经成功到达了交换机(Exchange),也可以理解为确认消息是否成功到达MQ。生产者实例可以在发送消息前可以开启confirm模式,打开confirm模式后,每个被投递到这个channel的消息都会分配一个唯一ID标识,当消息写入RabbitMQ之后,RabbitMQ会回传一个ack消息给生产者,ack消息包含消息的唯一ID标识,这样生产者就能知道消息被准确收到;如果RabbitMQ因为自身内部错误导致消息丢失,就会回传一个nack消息给生产者,这样就会调用一个我们处理nack消息的回调函数,在这个回调函数中我们可以写一些消息重发逻辑。
除了confirm还有一个renturn模式,用于确认消息是否从交换机成功到达队列,主要用于检查消息路由失败,如路由键错误或队列不存在等情况。renturn模式检查的是MQ内部的问题
MQ解决消息丢失问题主要通过持久化解决
- 无论是生产端也好还是消费端也好,在声明queue(队列)以及exchange(交换机)的时候将它们设置为可持久化的。除此之外,在生产者发送消息时,将消息的deliveryMode设置成持久化的,这样RabbitMQ就会将消息持久化到磁盘上,即使MQ宕机了,重启后也能从磁盘上恢复消息数据。这种方案一般是配合生产者的confirm模式共同使用,只有当消息被持久化到磁盘后,MQ才会发送ack消息通知生产端。如果需要进一步的保障,还可以使用集群、镜像队列、仲裁队列等
消费者解决消息丢失问题主要通过ack机制解决
- 默认的消息确认机制是消费者一收到消息,就会回一个ack消息给MQ,并且MQ一收到消费端的ack消息,就会将消息从内存或磁盘中移除。我们可以在消费者订阅队列时,关闭autoAck,关闭后消费端不会一收到消息会回ack,而是在业务处理完后,需要手动调用方法发送ack消息给MQ:channel.basicAck(),MQ也会一直等待直到消费端调用basicAck,回复确认消息后,才会将消息从内存或磁盘中移除。
集群架构
消息积压
处理 RabbitMQ 中的消息积压可以从很多方面考虑解决问题,比如在代码层面优化消费者代码逻辑,提升消费速度,或者直接提升硬件资源,提升消费速度,从RabbitMQ来考虑,可以有以下几个方法
- 增加消费者数量:
- 基于RabbitMQ一个队列可以负载多个消费者的特性,可以通过增加更多的消费者来提高消息的处理速度,从而减少队列中的积压。确保你的消费者程序能够并行处理消息。
- 使用优先级队列:
- 如果某些消息比其他消息更重要,可以使用优先级队列来确保这些消息被优先处理。
- 消息批处理:
- 允许消费者一次获取多条消息,而不是一条一条地处理。这可以通过设置
**<font style="color:rgb(44, 44, 54);">prefetch_count</font>**参数来实现,它告诉 RabbitMQ 在等待确认前可以发送给消费者多少消息。
- 允许消费者一次获取多条消息,而不是一条一条地处理。这可以通过设置
处理消息积压时,重要的是要根据具体的应用场景和资源限制选择最合适的方法。同时,持续监控系统性能和消息队列状态对于预防未来的问题也是至关重要的。
消息事务
RabbitMQ支持消息事务
在事务模式下,你可以将一系列的消息发布操作组合成一个原子性的操作。这意味着如果其中任何一个消息发布失败,整个事务都将被回滚,所有之前发布的消息都不会被提交。事务模式使用以下步骤:
- 调用
<font style="color:rgb(44, 44, 54);">channel.txSelect()</font>来开启一个事务。 - 发布一条或多条消息到队列或交换机。
- 调用
<font style="color:rgb(44, 44, 54);">channel.txCommit()</font>来提交事务,这将使所有消息都被提交。 - 如果在任何时候发生错误,可以调用
<font style="color:rgb(44, 44, 54);">channel.txRollback()</font>来回滚事务,取消所有之前的操作。
延时队列
1. 使用死信队列(DLX)
在 RabbitMQ 中,可以通过设置队列属性中的 <font style="color:rgb(44, 44, 54);">x-message-ttl</font> 参数来指定消息的最大存活时间。当消息的 TTL 过期后,它会被发送到预先配置的死信交换机(DLX),从而可以被路由到另一个队列供后续处理。
为了实现延时队列,你需要:
- 创建一个带有 TTL 设置的队列。
- 配置一个 DLX(死信交换机)。
- 将原队列与 DLX 绑定。
2. 使用 **<font style="color:rgb(44, 44, 54);">rabbitmq_delayed_message_exchange</font>** 插件
另一种实现延时队列的方法是使用 <font style="color:rgb(44, 44, 54);">rabbitmq_delayed_message_exchange</font> 插件。这个插件提供了一种类型的交换机——<font style="color:rgb(44, 44, 54);">x-delayed-message</font>,它能将消息延迟一定的时间后再发送给绑定的队列。
要使用这个插件:
- 首先,确保你已经安装了
<font style="color:rgb(44, 44, 54);">rabbitmq_delayed_message_exchange</font>插件。可以通过在命令行运行<font style="color:rgb(44, 44, 54);">rabbitmq-plugins enable rabbitmq_delayed_message_exchange</font>来启用它。 - 创建一个类型为
<font style="color:rgb(44, 44, 54);">x-delayed-message</font>的交换机。 - 在发送消息时,通过设置消息头部的
<font style="color:rgb(44, 44, 54);">x-delay</font>字段来指定延迟时间(单位为毫秒)。 - 该插件内部实现机制基于 RabbitMQ 的消息存储和定时任务调度实现