文章开头先介绍一篇非常好的文章:带你彻底认识 Paxos 算法、Zab 协议和 Raft 协议的原理和本质
简介
我们都知道分布式系统要遵守CAP原则,即一致性(Consistency)、可用性(Availability)、分区容错性(Partition tolerance)只能同时满足两个。
而zookeeper满足的是CP(需要注意这里的C是在选主的过程中会停止服务,而读写过程中并不是强一致性),但是做到一致性并不是那么容易,在科学家和程序员的不断探索中,就出现了很多的一致性协议和算法。比如 2PC(两阶段提交),3PC(三阶段提交),Paxos算法等等。
这里还要提到一个问题,就是信道可靠性的问题,如果消息在传输过程中就已经被修改过了,那么哪怕算法再厉害,最终也不可能做到一致性,所以这里就要提到拜占庭将军问题(在不可靠信道上试图通过消息传递的方式达到一致性是不可能的)
2PC协议
2PC协议具体过程分为两步
- 协调者告诉所有参与者可以进行事务,但不提交,并在执行完事务后,返回执行结果给协调者
- 协调者收到所有参与者的反馈之后,根据得到的反馈告诉所有参与者提交或者回滚
该协议非常简单,同时也有很多问题,尤为明显的就是过于依赖协调者,这将带来不少问题
- 协调者如果挂掉,整个系统都将不可用,当然了,可以考虑将协调者设为集群,那么协调者之间的一致性又变成了新的问题,这明显在使问题变复杂。
- 所有参与者过于依赖协调者的指令,如果执行完事务,因为网络等原因没有收到协调者的指令,将会一直处于等待的阶段,占用资源,并且第二阶段不是所有参与者都成功收到指令,极有可能造成数据不一致
3PC协议
3P协议具体过程分为3步
- CanCommit: 协调者向所有参与者发起请求,询问参与者是否可以进行事务,参与者收到请求后,向协调者反馈,有需要的可以直接做好准备
- PreCommit: 协调者根据上个步骤参与者的反馈向参与者发出执行事务或者取消事务的请求,参与者收到请求后进行相应的操作,如果是执行事务,则执行完后,将 Undo 和 Redo 信息写入事务日志中并反馈给参与者。需要注意,如果参与者在这个过程中长时间没有收到协调者的执行事务或者取消事物的请求,那么参与者将直接取消事务,因为这是参与者并不知道其他参与者是否可以进行事务,所以只能取消事务
- DoCommit: 协调者根据上个步骤参与者的反馈向参与者发出提交事务或者回滚事物的请求,参与者收到请求后进行相应的操作。需要注意如果参与者在这个过程中长时间没有收到协调者的提交事务或者回滚事务的请求,那么参与者将直接提交事务,因为经过第一个阶段,基本可以认为其他参与者都可以执行并且提交事务
可以看到,3PC比2PC多了一个CanCommit阶段并且加入了超时机制,CanCommit阶段可以提高事务执行成功的可能性并且是第三阶段超时机制的根据。超时机制的存在让参与者不在过分依赖协调者,有了一定的自主性,克服了2PC过于依赖协调者所导致的问题。但是3PC并不是就完事大吉了,因为超时机制本身就有一定的风险,并且通信次数过多提高了通信带来的风险。
Paxos算法
- 两个角色
- Proposer提案者:负责提出 proposal,同时它也是表决者,只不过对于自己的提案,默认同意,每个提案者在提出提案时都会首先获取到一个 具有全局唯一性的、递增的提案编号N,即在整个集群中是唯一的编号 N,然后将该编号赋予其要提出的提案,在第一阶段是只将提案编号发送给所有的表决者。
- Acceptor表决者:每个表决者在 accept 某提案后,会将该提案编号N记录在本地,这样每个表决者中保存的已经被 accept 的提案中会存在一个编号最大的提案,其编号假设为 maxN。每个表决者仅会 accept 编号大于自己本地 maxN 的提案,在批准提案时表决者会将以前接受过的最大编号的提案作为响应反馈给 Proposer
- Learner学习者:即不参与表决的角色,当一个提案被通过后,学习者再从提案者或者表决者那里获取提案
- 两个阶段
- prepare阶段:提案者获取一个提案编号,并将获取的提案编号发送给所有表决者,表决者收到提案编号后,与自己本地最大的提案编号进行对比,如果新的提案编号大于本地最大的提案编号,将本地的提案编号更新,批准提案并返回结果给提案者,如果新的提案编号不大于本地最大的提案编号,则不批准并返回本地最大提案编号以及提案内容给提案者(这一步可以理解为通过对比拿到集群中最大编号的提案)
- accept阶段:提案者收到一半以上表决者批准的消息后,如果有收到表决者反馈提案编号大于本次提案编号,则以收到的编号和内容为准,重复第一阶段,将提案编号与提案内容提交给表决者,表决者收到提案后,接受提案内容并返回结果给提案者,如果提案者收到一半以上表决者同意的消息,那么会继续发消息让不同意的表决者无条件的接受提案,到这一步同时会涉及到一个learner学习的过程,即提案者会将本次提案也提交给学习者,或者表决者推送给学习者
Paxos算法也有他的不足,就是如果同时存在多个提案者的时候,容易造成死循环,不过可以限定只能有一个提案者就可以了。
Multi-Paxos协议就是Paxos的基础上限定了一个提案者成为Leader,如果没有Leader或者Leader宕机了,则通过prepare阶段选举Leader,所以当Leader的存在时可以不再进行prepare阶段,因为Leader的特点保证它的提案编号一定会是最大的
ZAB协议
作为一个优秀高效且可靠的分布式协调框架,ZooKeeper 在解决分布式数据一致性问题时并没有直接使用 Paxos ,而是专门定制了一致性协议叫做 ZAB(ZooKeeper Atomic Broadcast) 原子广播协议,该协议能够很好地支持崩溃恢复
先了解一些基本概念
- electionEpoch:每执行一次 leader 选举,electionEpoch 就会自增,用来标记 leader 选举的轮次
- peerEpoch:每次 leader 选举完成之后,都会选举出一个新的 peerEpoch,用来标记事务请求所属的轮次
- zxid:事务请求的唯一标记,由 leader 服务器负责进行分配高 32 位是上述的 peerEpoch,低 32 位是请求的计数,从 0 开始。
- lastprocessZxid:最后一次 commit 的事务请求的 zxid
- LinkedList committedLog、long maxCommittedLog、long minCommittedLog:ZooKeeper 会保存最近一段时间内执行的事务请求议案,个数限制默认为 500 个议案。committedLog 就是用来保存议案的列表,maxCommittedLog 表示最大议案的 zxid,minCommittedLog 表示 committedLog 中最小议案的 zxid。
- ConcurrentMap<Long, Proposal> outstandingProposals:Leader 拥有的属性,每当提出一个议案,都会将该议案存放至 outstandingProposals,一旦议案被过半认同了,就要提交该议案,则从 outstandingProposals 中删除该议案。
- ConcurrentLinkedQueue toBeApplied:Leader 拥有的属性,每当准备提交一个议案,就会将该议案存放至该列表中,一旦议案应用到 ZooKeeper 的内存树中了,然后就可以将该议案从 toBeApplied 中删除。
- state:当前服务器的状态
- recvQueue:消息接收队列,用于存放那些从其他服务器接收到的消息。
- queueSendMap:消息发送队列,用于保存那些待发送的消息,按照 SID 进行分组。
- senderWorkerMap:发送器集合,每个 SenderWorker 消息发送器,都对应一台远程 Zookeeper 服务器,负责消息的发送,也按照 SID 进行分组。
- lastMessageSent:最近发送过的消息,为每个 SID 保留最近发送过的一个消息。
- 三个角色
- Leader 领导者、Follower跟随者、Observer观察者 (在zookeeper基础中介绍过)
- 两个模式
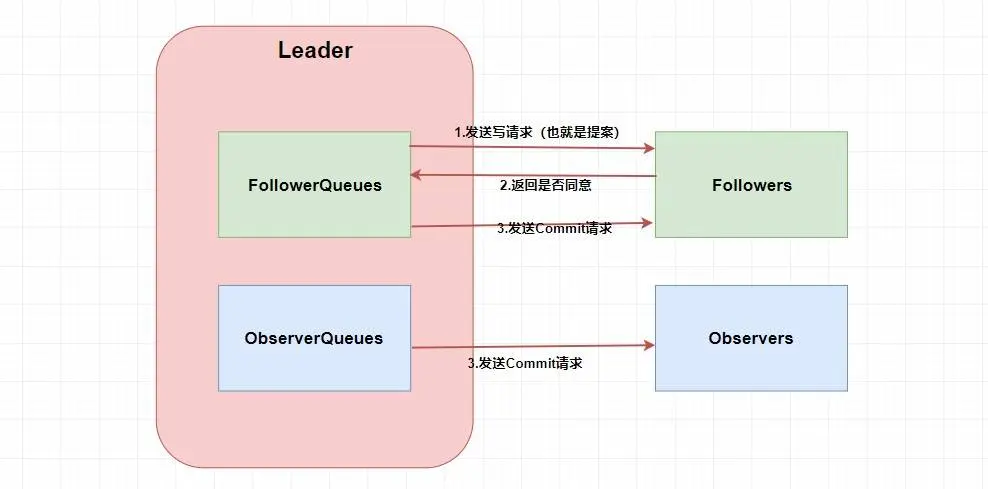
- 消息广播模式:我们可以理解为zookeeper的写机制,当客户端写入数据到zookeeper集群,数据首先会写入Leader,随后Leader将消息广播给Follwer,Follwer接收完消息后并反馈给Leader,Leader收到一半以上的反馈后,返回客户端zxid(每次写操作唯一的事务id),代表写入成功(从这里可以看出zookeeper的写操作不是强一致性,即客户端收到写入成功时并不保证zookeeper所有节点均已成功写入数据),并将消息广播给Observer

- 奔溃恢复模式:我们可以理解为Leader的选举机制,从字面意思可以看出是当Leader宕机时触发的机制,但其实zookeeper集群初始化选择Leader也是采取这个机制。
- 具体过程:每个节点发起投票,首先投票给自己,投票内容为(myid,zxid),随后将投票内容广播出去,每个节点收到其他节点的投票内容后,与自己的投票内容作比较,如果zxid大于本地的zxid(如果zxid等于,则比较myid),则更新自己的投票并广播出去,最后当一个节点收到了超过一半的票时,就把自己设为Leader,其他节点设为Follower并根据Leader更新提案(数据)。需要注意,如果上一个Leader宕机时,还有数据没有广播到其他节点,当上一个Leader恢复而其他节点又已经选出了Leader时,上一个Leader的数据就会被抛弃(确保已经被Leader提交的提案最终能够被所有的Follower提交 和 跳过那些已经被丢弃的提案 。)
- 例子:
- 消息广播模式:我们可以理解为zookeeper的写机制,当客户端写入数据到zookeeper集群,数据首先会写入Leader,随后Leader将消息广播给Follwer,Follwer接收完消息后并反馈给Leader,Leader收到一半以上的反馈后,返回客户端zxid(每次写操作唯一的事务id),代表写入成功(从这里可以看出zookeeper的写操作不是强一致性,即客户端收到写入成功时并不保证zookeeper所有节点均已成功写入数据),并将消息广播给Observer
假设我们集群中有3台机器,那也就意味着我们需要两台以上同意(超过半数)。比如这个时候我们启动了 server1 ,它会首先 投票给自己 ,投票内容为服务器的 myid 和 ZXID ,因为初始化所以 ZXID 都为0,此时 server1 发出的投票为 (1,0)。但此时 server1 的投票仅为1,所以不能作为 Leader ,此时还在选举阶段所以整个集群处于 Looking 状态。
接着 server2 启动了,它首先也会将投票选给自己(2,0),并将投票信息广播出去(server1也会,只是它那时没有其他的服务器了),server1 在收到 server2 的投票信息后会将投票信息与自己的作比较。首先它会比较 ZXID ,ZXID 大的优先为 Leader,如果相同则比较 myid,myid 大的优先作为 Leader。所以此时server1 发现 server2 更适合做 Leader,它就会将自己的投票信息更改为(2,0)然后再广播出去,之后server2 收到之后发现和自己的一样无需做更改,并且自己的 投票已经超过半数 ,则 确定 server2 为 Leader,server1 也会将自己服务器设置为 Following 变为 Follower。整个服务器就从 Looking 变为了正常状态。
当 server3 启动发现集群没有处于 Looking 状态时,它会直接以 Follower 的身份加入集群。
还是前面三个 server 的例子,如果在整个集群运行的过程中 server2 挂了,那么整个集群会如何重新选举 Leader 呢?其实和初始化选举差不多。
首先毫无疑问的是剩下的两个 Follower 会将自己的状态 从 Following 变为 Looking 状态 ,然后每个 server 会向初始化投票一样首先给自己投票(这不过这里的 zxid 可能不是0了,这里为了方便随便取个数字)。
假设 server1 给自己投票为(1,99),然后广播给其他 server,server3 首先也会给自己投票(3,95),然后也广播给其他 server。server1 和 server3 此时会收到彼此的投票信息,和一开始选举一样,他们也会比较自己的投票和收到的投票(zxid 大的优先,如果相同那么就 myid 大的优先)。这个时候 server1 收到了 server3 的投票发现没自己的合适故不变,server3 收到 server1 的投票结果后发现比自己的合适于是更改投票为(1,99)然后广播出去,最后 server1 收到了发现自己的投票已经超过半数就把自己设为 Leader,server3 也随之变为 Follower。