集群搭建
早期Kafka只支持使用Zookeeper来协调服务,管理集群状态以及元数据,后面的版本出现KRaft代替Zookeeper,出现了Controller节点用于协调服务,管理集群状态以及元数据
这里启动一个Controller,两个Broker测试,这里需要注意Kafka节点之间不存在主从,只有单个分区内部多个分片存在主从关系
启动
第一个节点
启动第一个节点,这个节点同时作为Controller、Broker,这里用server.properties作为配置模板,下面是一些主要的配置
1 | ############################# 服务器基础设置 ############################# |
格式化日志目录,这里的KAFKA_CLUSTER_ID随便取一个,只要两个节点的一致即可
1 | kafka-storage.bat format -t <KAFKA_CLUSTER_ID> -c ..\..\config\kraft\server.properties |
启动节点
1 | kafka-server-start.bat ..\..\config\kraft\server.properties |
第二个节点
启动第二个节点,这个节点仅作为Broker,这里用broker.properties作为配置模板,下面是一些主要的配置,主要就上面几个配置有点区别
1 | ############################# 服务器基础设置 ############################# |
格式化日志目录,这里的KAFKA_CLUSTER_ID随便取一个,只要两个节点的一致即可
1 | kafka-storage.bat format -t <KAFKA_CLUSTER_ID> -c ..\..\config\kraft\server.properties |
启动节点
1 | kafka-server-start.bat ..\..\config\kraft\server.properties |
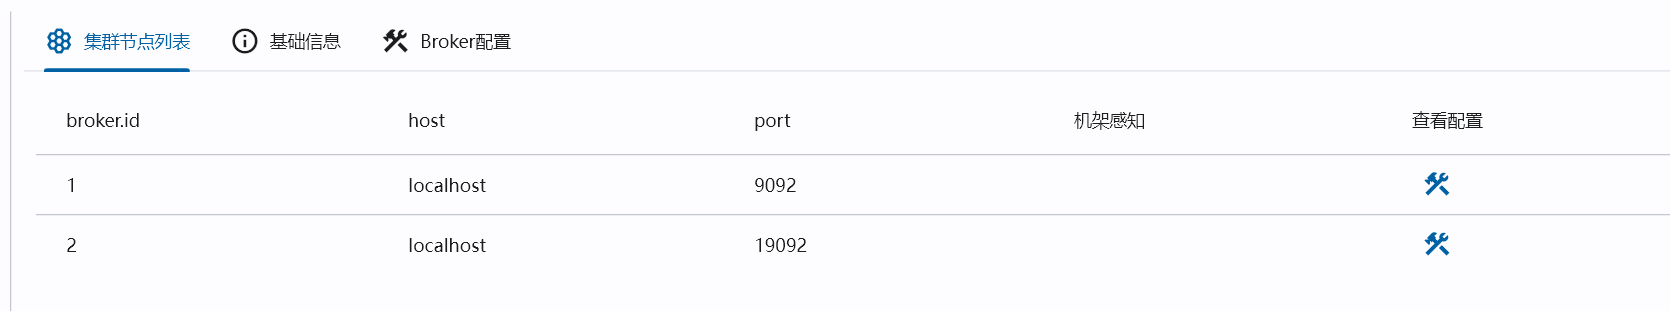
通过Kafka-King可以看到集群搭建成功了,创建一个Topic
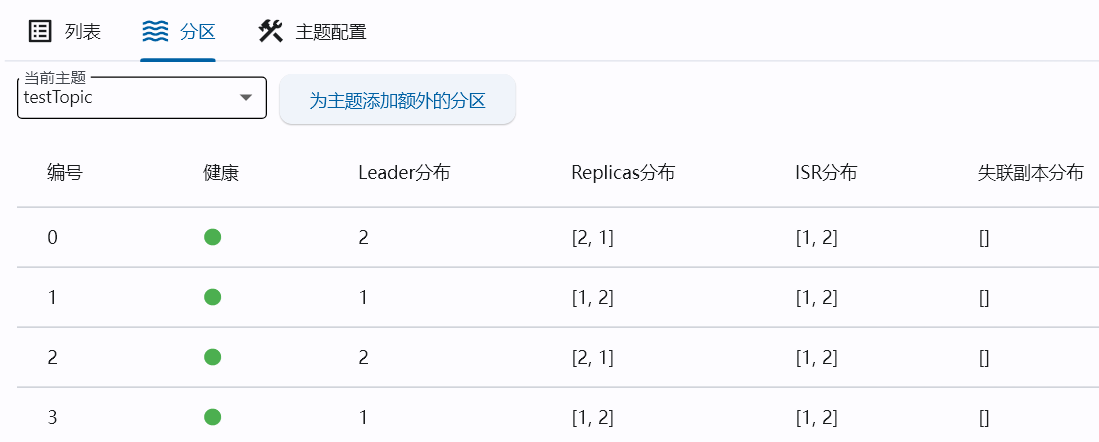
可以看到,四个分区,0、2两个分区的leader在19092的节点上,1、3两个分区的leader在9092的节点上
集群特点
同步副本机制
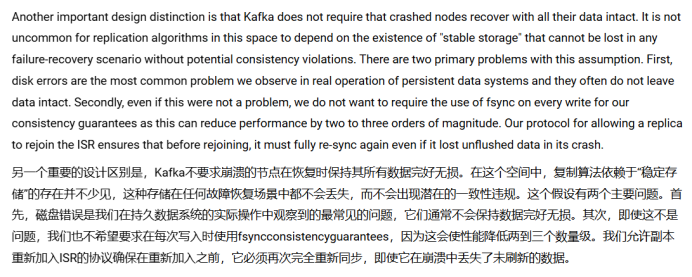
Kafka集群,Controller通过Raft算法构成集群,所以拥有Raft算法所有特性,对于Broker,Kafka动态维护一组赶上领导者的同步副本(ISR),任何消息必须同时写入leader和ISR中的所有副本才被Kafka确认为写入成功
同步副本机制的优点
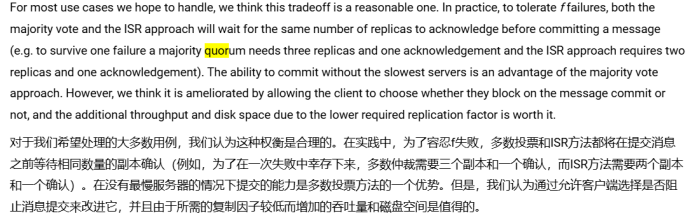
Kafka之所以不采用Raft算法管理副本,主要是基于数据量的考虑,我们基于Raft协议的多数派协议可知(防止脑裂),集群必须存活至少一半的副本,才能正常运行,即如果要容忍一个副本下线,需要三个副本(这里的副本包括leader),要容忍两个副本下线,则需要五个副本,依此类推,Kafka认为对于存储大量数据的系统来说是不合适的,更适用于管理数据配置等数据量比较小的系统,例如Zookeeper
同步副本机制的缺点
- 首先就是分布式中的一个难题,脑裂问题,所以Kafka的选主不是副本内部进行的,而必须通过Zookeeper或者KRaft
- 第二个问题就是速度问题,因为Kafka的消息必须由ISR中的所有副本确认才被确认写入成功,如果ISR中的某个副本响应非常慢,则容易导致整体消息写入的响应速度,虽然Kafka生产者可以控制不等待所有ISR确认,但是这样就会损失安全性。而多数派协议只需要任意半数以上的副本确认即可,所以并不受限于某个副本的响应速度。第二个问题是Kafka没能解决的,但是Kafka认为是值得的

Kafka官方还有下面一段