官网
GitHub - apache/kafka: Mirror of Apache Kafka
中文版本(版本比较低,可以稍微参考):
Kafka安装
下载
官网下载:https://kafka.apache.org/downloads
启动
基于KRaft模式启动Kafka
Kafka早期只支持使用zookeeper作为协调者,kafka2.8.0开始,出现了KRaft代替zookeeper,KRaft下分为两种身份,一种是controller,负责管理集群,一种broker,负责存储数据,一个节点可以同时是两种身份,也可以只是其中一种,通过配置文件控制
这里先介绍一下config\kraft目录下三个配置文件,三个文件除了具体配置不同外,并无区别
- broker.properties:仅以broker身份启动
- controller.properties:仅以controller身份启动
- server.properties:同时以controller、broker身份启动
这里的环境是windows,所以进入kafka的bin\windows目录执行相关命令
- 生成集群id,这里不一定需要通过该命令,保证不同集群id不一样即可
1 | kafka-storage.bat random-uuid |
- 格式化日志目录,这里的KAFKA_CLUSTER_ID就是上面的id,具体的目录日志在配置文件中
1 | kafka-storage.bat format -t <KAFKA_CLUSTER_ID> -c ..\..\config\kraft\server.properties |
- 启动kafka
1 | kafka-server-start.bat ..\..\config\kraft\server.properties |
启动遇到的问题
第一个问题就是Java版本的问题,最新的kafka已经不支持Java8了(可能之前就不支持了),所以这一点需要注意
第二个问题就是kafka命令的问题,kafka-run-class.bat对于classpath是将每一个jar包的名称都拼接起来,有可能导致命令过长而执行失败,可将相关命令直接改为以下命令,具体查看kafka-run-class.bat文件
1 | set CLASSPATH=%CLASSPATH%;%BASE_DIR%"\libs\*" |
配置
官方相关配置介绍文档:https://kafka.apache.org/documentation/#configuration
中文介绍(版本比较低):https://kafka1x.apachecn.org/documentation.html#configuration
可视化
Kafka官方并没有推出可视化工具,这里使用开源工具KafkaKing
官方地址:https://blog.ysboke.cn/posts/tools/kafka-king
下载地址:https://github.com/Bronya0/Kafka-King/releases
下载后,直接启动exe文件即可
Kafka结构
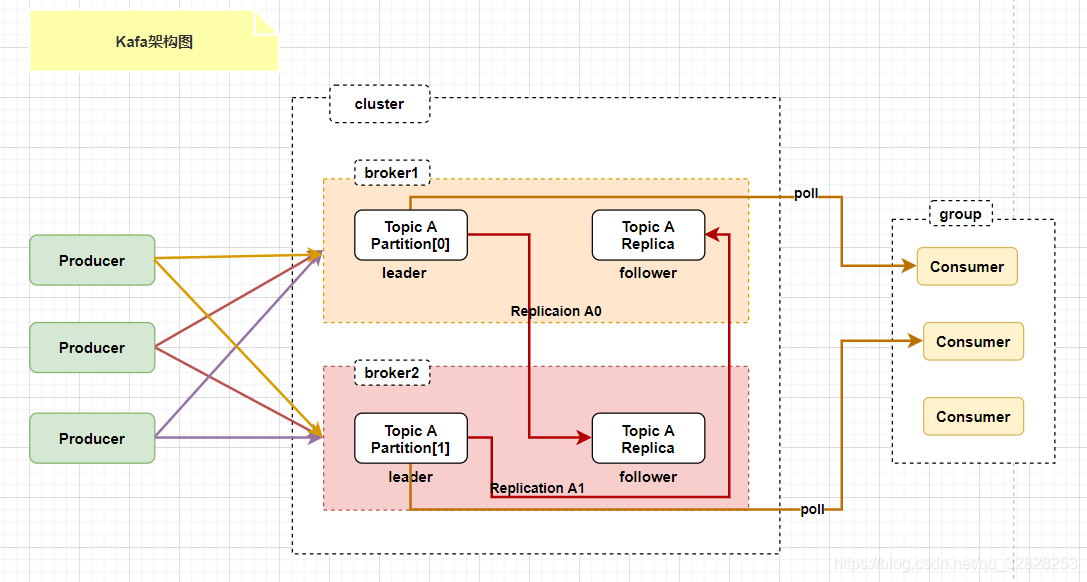
- Broker:主要负责消息的存储、投递和查询以及服务高可用保证。
- 生产者:向Broker发送消息,Kafka为了提高性能,生产者的消息不会直接推送给Broker,而是先暂存在内存中,等到一定的时机,再批量发送给Broker,生产者可以通过batch.size和linger.ms控制时机
参考文档:https://zhuanlan.zhihu.com/p/482447582 - 消费者:从Broker消费消息
- 消费者组:多个消费者组成的消费者组,是Topic向消费者发送消息的一个逻辑分组,Topic会将消息发送给所有订阅的消费者组,同一个topic下的Partition对于一个消费者组都将分配一个消费者,如果消费者少于Partition,则多个Partition分配同一个消费者,如果消费者多于Partition,则每个Partition分配一个消费者后,剩余消费者将空闲,如果有消费者组内有新的消费者或者有消费者出现问题,比如下线了,那么将重新分配
- Topic:消息主题,类似RocketMQ的Topic,消息传输和存储的顶层容器(逻辑容器),用于标识同一类业务逻辑的消息,可以理解为消息分组,所有消息都会属于一个Topic,生产者以Topic为目标投递消息,消费者也以Topic为目标消费消息,5.0开始,特定类型的消息只能投递到特定类型的Topic
- Partition:分区,类似RocketMQ的Queue,消息存储和传输的实际容器,也是消息的最小存储单元,Topic由多个Partition组成,消息储存在Partition,而Partition属于Topic,物理意义上,生产者的消息直接投递到Partition,而消费者直接从Partition获取消息。不同的是,Kafka的每个Broker只会包含Topic中的部分Partition(即不会重复),而RocketMQ中的每个Broker都会包含Topic的所有队列
- Replica:副本,可以理解为Partition的拷贝,并且Kafka支持分区故障转移Partition下线后,副本可以晋升为Partition,Kafka与RocketMQ不同的地方之一,Kafka的副本是基于分区的,而RocketMQ的副本是基于节点的,基于此特性,Kafka的Broker都是一个节点,但是它们不是互相独立的,而RocketMQ的Broker一般由多个节点组成,但是不同的Broker都是互相独立的
消息顺序性
从Kafka的结构来看,消息的传递简单来说就是从生产者推送到分区,分区再推送到消费者,只是这两步都受到很多逻辑的控制,而且消息的顺序性又涉及到全局顺序性和局部顺序性,这里默认生产者同步生成和消费者同步消费
- 全局顺序性:全局顺序性的要求下,那么Kafka只能有一个生产者,一个分区,一个消费者
- 局部顺序性:局部顺序性的要求下,即将按类别保证消息顺序性,那么要保证同一类别消息从同一生产者生产,并且投递到同一分区,再由同一消费者消费
- 保证同一类别消息由同一生产者生产,这一步很好保证
- 保证同一类别消息进入同一分区,Kafka支持在发送消息时就确定投递到哪个分区,不过并不是直接设置某个消息,而是为生产者设置一个分区选择器,我们自定义实现分区选择的逻辑
1 | public class CustomizePartitioner implements Partitioner { |
3. 要保证由同一消费者消费,由于Kafka消费者组内,保证只有一个消费者消费一个分区的内容,所以这一步是很好实现
消息持久性
参考文档:https://zhuanlan.zhihu.com/p/420963323
Kafka持久化主要包括log、index、timeindex三个文件,这三个文件都是分区下面
- log:消息的实际存储文件,类似于RocketMQ的CommitLog,但是kafka的每个分区的消息都直接存储在分区文件夹下面的log文件,而RocketMQ单节点所有主题、队列的消息都是存储在统一的文件夹中,这一点有点不同
- index:索引文件,类似于RocketMQ的ConsumeQueue,但只包括两个值,一个是消息偏移量(offset),另一个是消息在log中的位置(position),并且由于index采用的稀疏结构(不会存储每一条消息的索引),所以不能像RocketMQ一样,通过计算位置获取索引,只能通过二分查找,根据offset找到一个具体的的position或者范围,在到log文件中进行查找
- timeindex:Kafka提供的一种通过时间查询消息的方式,也只有两个值,一个是时间,另一个是消息偏移量(offset),也是稀疏结构,查询过程先通过二分查找找到具体的offset或者范围,在通过查询出的offset到index查询具体的position或者范围,在到log文件中进行查找
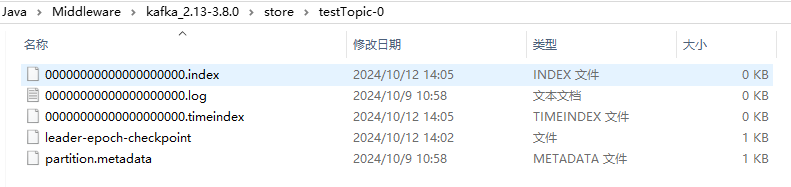
Kafka关于偏移量的持久化,在早期的Kafka版本中,是保存在zookeeper中,后期的版本会将偏移量推送到一个名为__consumer_offsets的主题中
消息模式
发布-订阅模式 (Publish-Subscribe)
Kafka是在消费者组的基础上实现的发布-订阅模式,不同的消费者组订阅同一个主题,每个消费者组可以独立地读取主题中的消息,而不会影响其他消费者组
点对点模式 (Point-to-Point)
在消费者组内部,消费者接收消息是点对点模式,即对于主题中的一条消息,只会被消费者组内部一个消费者读取,具体的实现是主题中的同一个分区的消息只会被消费者组内的同一个消费者读取,即分区与消费者是多对一的关系,在分区或者消费者发生变化时,会重新分配
消费模式
虽然Kafka和RocketMQ本质上都只支持pull模式,但是Kafka的pull模式和RocketMQ有一点区别
- RocketMQ的pull模式是将偏移量存储在Broker,拉取时要先从Broker获取偏移量后再执行获取消息的流程
- 而Kafka的pull模式是将偏移量存储在消费者,消费者在拉取时会带上偏移量直接拉取,并且由于Kafka不存在消费者负载消费同一个分区的情况,所以Kafka消费者自己管理偏移量是很简单的
//注:偏移量虽然是由消费者自己管理,但是会持久到Kafka,具体实现是将偏移量推送到Kafka一个名为“__consumer_offsets”的主题中以持久,消费者重启时从这个主题中获取之前的偏移量
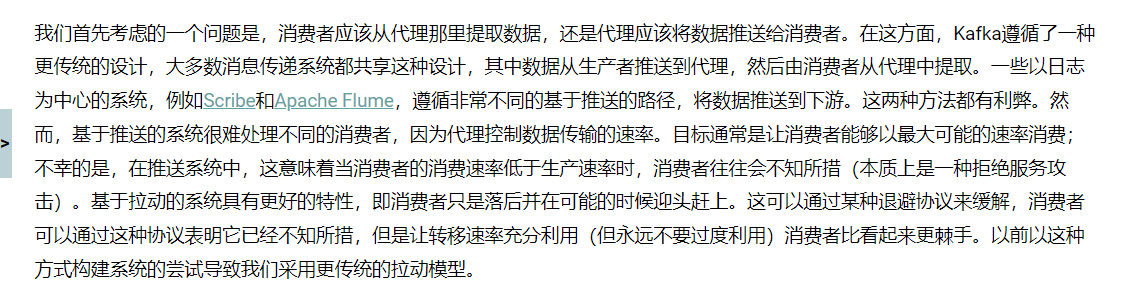
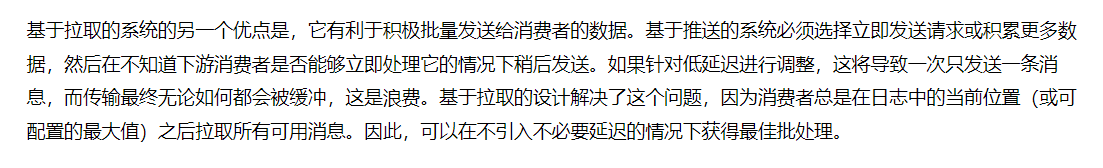
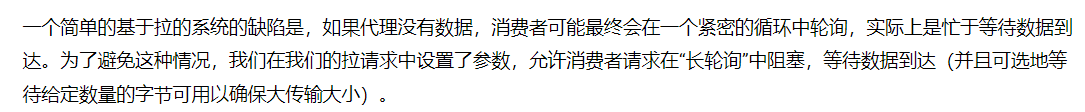
Kafka本身只支持pull模式,在官网中也给出了具体理由
总结一下为:
- push模式下,Broker如果消息推送过快,可能超出消费者的消费能力,容易出现不可控的情况
- pull模式对于批量消费的场景非常有用,这更符合Kafka的设计
- 对于pull模式的弊端,可以通过长轮询(如果没有消息,Broker会将请求挂起,直到有消息或者超时才返回)解决
消息过滤
Kafka并没有直接提供给像RocketMQ那种通过tag或者sql过滤的方式,只能自己在消费者端编写过滤代码,不过spring-kafka提供了模板,还是比较方便的,除了自己编写过滤代码,还可以考虑使用以下两种方案
- 使用Kafka Streams:Kafka Streams 是一个用于构建实时数据处理应用程序的轻量级 Java 库。它允许开发者直接在 Kafka 中处理数据流,支持复杂的转换、聚合和连接操作,并且可以嵌入到任何 Java 应用程序中,无需额外的集群部署。Kafka Streams 提供了容错性和可扩展性,确保数据处理的一致性和可靠性。可以引入Kafka Streams以实现复杂的过滤
- KSQL:KSQL 是一个用于 Apache Kafka 的流式 SQL 引擎,它允许用户通过 SQL 语句来查询、处理和分析实时数据流。KSQL 提供了类似于传统 SQL 的语法,使得开发者可以轻松地进行复杂的流处理操作,而无需编写底层的流处理代码
消息丢失
生产者可通过设置生产者的acks参数保证消息成功到达Broker
acks包括三个参数:0,1,-1
- 0:Kafka不返回确认给生产者,容易丢消息
- 1:Kafka在leader确认之后就返回确认给生产者,会丢消息,因为光leader确认,如果ISR中的副本没有完全确认的话,该消息不会被认为写入成功
- -1:alls,Kafka会在leader和所有ISR中的副本都确认之后才返回确认给生产者
Broker可通过设置刷盘策略以及搭建集群保证
Kafka不像RocketMQ支持同步刷盘,但是Kafka支持设置刷盘相关的参数,提供了基于消息数量、基于消息内存存储时间以及定期刷盘三种方式
- log.flush.interval.messages:在将消息刷新到磁盘之前,在日志分区上累积的消息数量。
- log.flush.interval.ms:在刷新到磁盘之前,任何topic中的消息保留在内存中的最长时间(以毫秒为单位)。如果未设置,则使用log.flush.scheduler.interval.ms中的值。
- log.flush.scheduler.interval.ms:日志刷新器检查是否需要将所有日志刷新到磁盘的频率(以毫秒为单位)
kafka之所以没有提供同步刷盘,是Kafka认为备份比磁盘更可靠
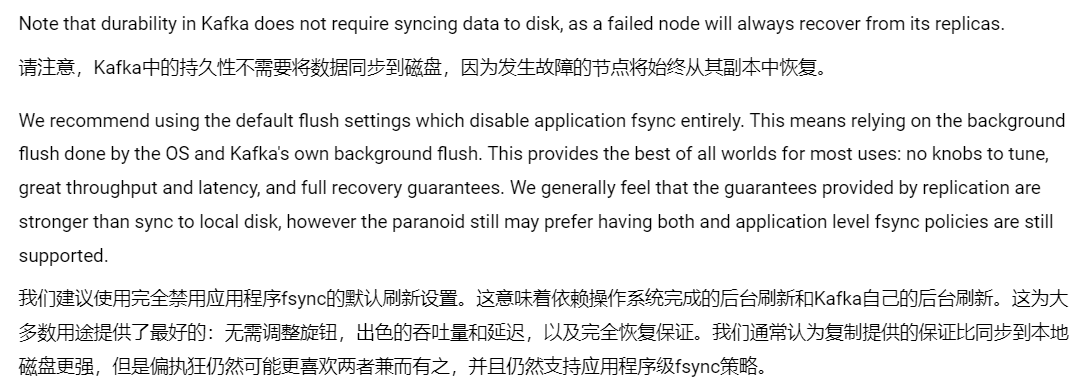
Kafka的设计似乎都是基于多节考虑的,所以Broker保证消息不丢更多还是要考虑通过集群的方式,Kafka在集群下通过ISR,可以对消息提供很强的保护
消费者可通过手动提交偏移量保证消息被消费者消费
- 手动提交偏移量:由于Kafka的消费偏移量是由消费者自己管理,只需要避免在消费失败的时候更新偏移量,所以采用手动提交偏移量,确保消费状态与偏移量的一致性
这里其实不采用手动提交偏移量的话,消费者是不是在消费失败的时候,不会更新本地偏移量,更不会提交偏移量了,因为这一步对消费者来说是可控的(具体需要通过查看源码才能确定)
集群架构
消息积压
当Kafka集群出现消息积压时,可以从很多方面考虑解决问题,比如在代码层面优化消费者代码逻辑,提升消费速度,或者提升硬件资源,提升消费速度,采用外部存储,减少Kafka压力等。从Kafka来考虑,可以考虑以下两点
- 增加消费者数量:
- 根据分区数量来增加消费者实例,使得每个消费者负责的分区更少,从而提高整体消费速率。
- 确保消费者组的数量不超过主题的分区数,如果已经达到了分区数,就需要修改一个或者多个消费者,将它作为中转站,将该topic的消息复制到一个新的很多分区的topic,这样就可以创建更多的消费者,复制这一步Kafka Stream似乎可以作为一个很好的选择
- 使用批处理技术:
- 使用批处理技术,批量拉取消息而不是逐条处理。
消息事务
延时消息
虽然网上有很多基于Kafka实现延时消息的方案,但是Kafka本身并不支持延时消息,不仅如此,像Broker端的消息过滤,Kafka也不支持