由于 Erlang 语言的分布式特性,RabbitMQ 自然地支持集群部署。RabbitMQ 集群可以提供高可用性、可伸缩性和容错能力。
集群搭建
集群搭建有两种方式,一种是通过命令的方式手动添加,一种是通过配置的方式添加
无论是命令方式还是配置方式,都需要保证所有节点.erlang.cookie的内容一致,直接复制.erlang.cookie文件,或者复制里面的内容都是可以的,具体路径参考官方文档
Windows:%HOMEDRIVE%%HOMEPATH%.erlang.cookie
Linux:/var/lib/rabbitmq/.erlang.cookie
命令方式
1 | rabbitmqctl stop_app |
通过命令方式需要注意
- 一是需要注意hostname必须是被加入rabbitmq的主机名,或者说必须是被加入rabbitmq的名字
- 二是需要配置hosts,因为加入集群,需要可以直接访问到被加入rabbitmq的主机,这里最好每个节点都配置好其他的ip,以避免意外情况,如果只用docker容器,可以通过在启动命令中加入“–link”参数配置容器的hosts
配置方式
配置方式可参考https://www.rabbitmq.com/docs/cluster-formation
rabbitmq提供了很多种发现机制,比如配置文件里面配置好
1 | cluster_formation.peer_discovery_backend = rabbit_peer_discovery_classic_config |
通过配置方式需要注意两点
- 一是和命令方式一样,需要配置hosts,而且集群中每台服务器都配置,以避免意外情况
- 二是需要注意通过配置文件配置节点,只会在首次启动尝试加入集群,这里的首次启动指的是安装后的首次启动,后发现是mnesia数据库构建之前启动,即如果删除rabbitmq本地mensia数据库后,再次启动也会尝试加入集群。rabbitmq其他发现机制没有该问题,比如使用Consul
集群特点
- 节点间通信:
- 集群中的每个节点都是独立的RabbitMQ实例,它们通过网络相互通信。
- 节点之间共享元数据,如队列、交换器、绑定、用户和权限信息。
- 队列位置:
- 当消息被发布到队列时,消息实际只存储在创建队列的节点上。
- 其他节点上只保留队列的元数据,而不包含消息的实际内容。
- 消息处理:
- 消费者可以连接到集群中的任意节点来消费消息。
- 如果消费者连接的节点不是队列所在的节点,那么该节点会代理请求到队列所在的节点。
- 高可用性限制:
- 如果存储有队列的节点发生故障,该队列将变得不可用,直到该节点恢复或重新创建队列。
- 为了解决这个问题,通常会结合使用镜像队列或其他高可用性策略。
- 性能优势:
- 普通集群可以通过水平扩展增加消息处理能力,提高整体吞吐量。
- 由于消息不跨节点复制,因此减少了网络带宽和存储资源的需求。
- 需要注意,以上内容中所说的队列仅指普通队列,因为rabbitmq在3.8版本中引入仲裁队列,需要区分开来
- 节点运行时会保存一份当前存活节点,因意外重新上线后,会尝试从之前保存的存活节点同步信息(这里不是指队列数据,同步队列数据是之后的事),因为最新的元数据肯定在之前存活的节点之一上面,如果同步失败,则无法正常启动
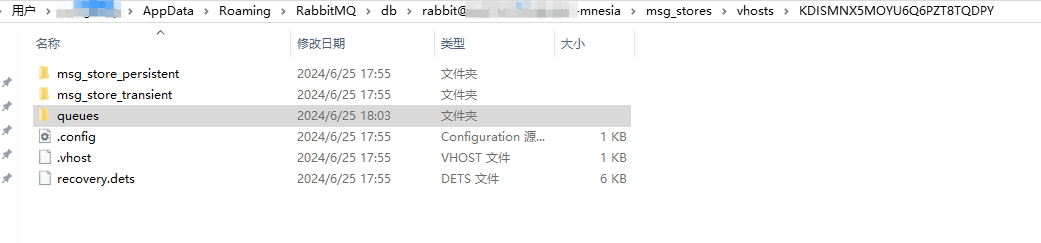
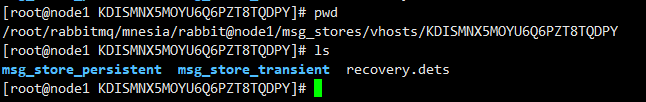
从上面两图可以看出,一个节点存储了queue队列数据信息,一个节点没有存储queue队列数据信息
镜像队列
镜像队列是普通队列的高可用模式,主要是完善了普通集群下,普通队列不同步队列数据的问题,但是也因为数据同步,导致了更大的网络开销
配置
镜像队列通过配置策略实现
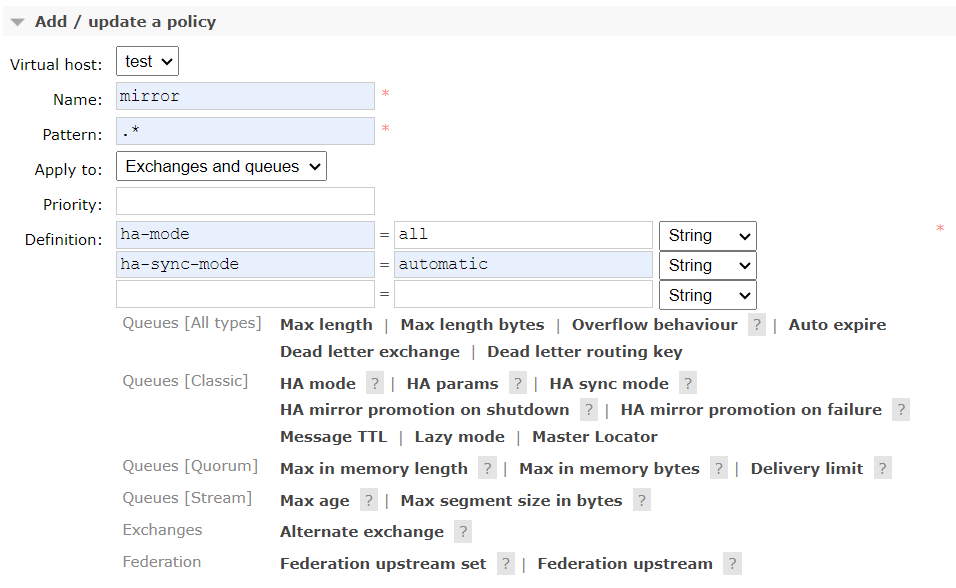
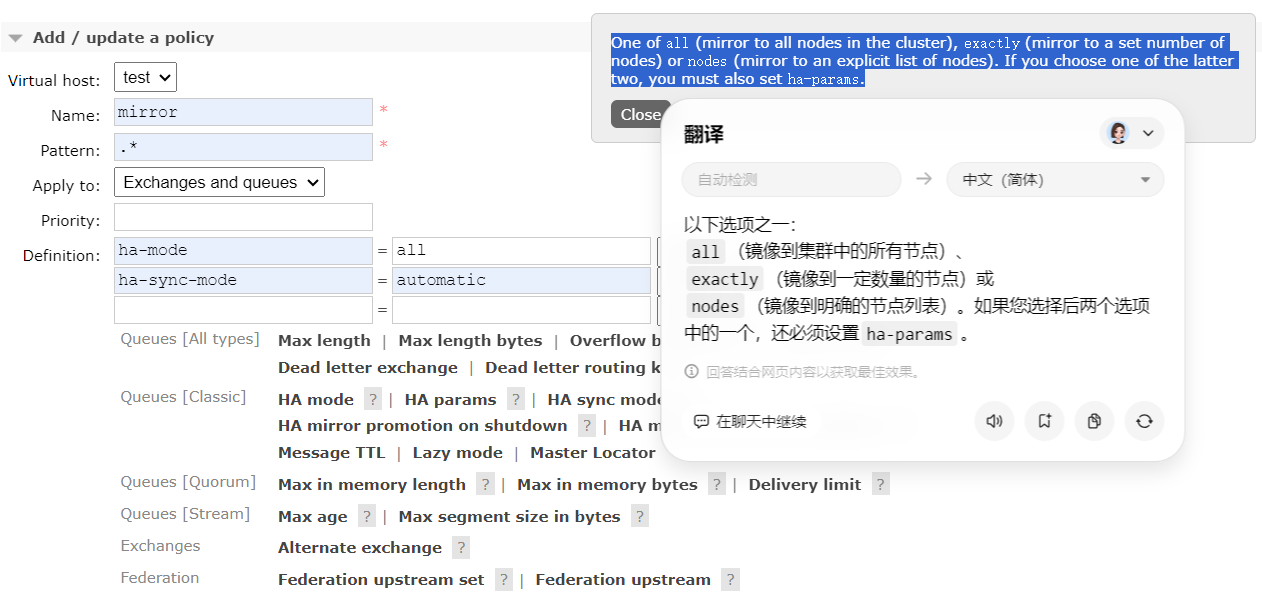
其中:
- name:策略名
- pattern:模式(正则表达式模式),设置匹配匹配哪些队列,设置“.*”表示匹配全部
- apply to:应用于,选择应用于队列还是交换机或者两者都选择,
- priority:优先级,在多个策略的情况下适用
- definition:定义,设置参数。下面列出了可配置的参数,例如针对所有队列有,Max Length,Max Length bytes等,还有针对不同队列的参数。
HA mode参数就是经典队列的对象模式:all、exactly、nodes
HA sync mode参数就是设置是否自动同步,这里的自动同步针对的是哪些新加入的节点,以及重新上线的节点(重新上线的节点会将队列清空)
特点
- 主从架构:
- 每个镜像队列有一个主节点(Master)和零个或多个从节点(Slaves)。
- 所有对队列的操作首先发生在主节点上,然后由主节点将操作的结果同步到所有从节点。
- 主节点负责处理队列的写入(发布)和读取(消费)操作。
- Policy配置:
- 镜像队列通常是通过策略(Policy)在RabbitMQ中配置的。
- 策略可以指定队列的镜像级别,比如可以设置队列必须在所有节点上镜像,或者只在特定数量的节点上镜像。
- 高可用性:
- 如果主节点发生故障,RabbitMQ会自动选择一个从节点作为新的主节点,从而保证了队列的连续可用性。但是对于未同步的从节点成为新的主节点受很多条件和参数控制,比如当主动关闭主节点时,未同步的从节点无法升级为主节点
- 性能考量:
- 尽管镜像队列提高了高可用性,但同时也增加了网络通信和磁盘I/O的开销,因为每条消息都需要在多个节点间复制。
- 因此,镜像队列的使用应该基于对高可用性和性能需求的平衡。
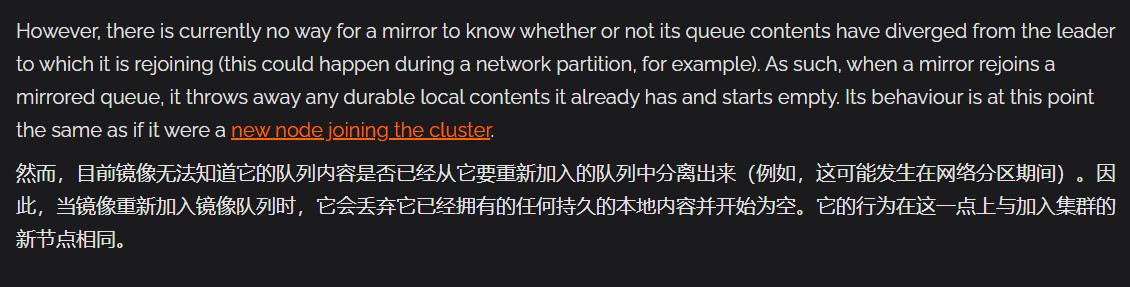
- 宕机清空:
- 当一个节点下线,然后恢复上线之后,它保存的所有从队列的镜像数据都会丢失,这是为了防止发生了网络分区等情况导致的数据问题。如果此时设置HA sync mode参数为automatic,那么会自动同步,如果设置为manual,那么需要技术人员衡量是否同步老数据。在同步的问题上,新加入的节点同理
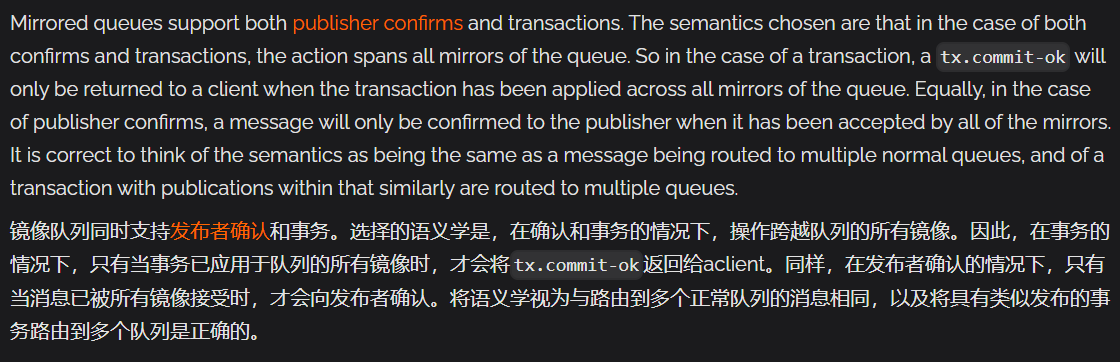
- 一致确认
- 当生产者开启confirm或者事务时,提交到rabbitmq的消息需要应用到所有节点才会返回确认给生产者
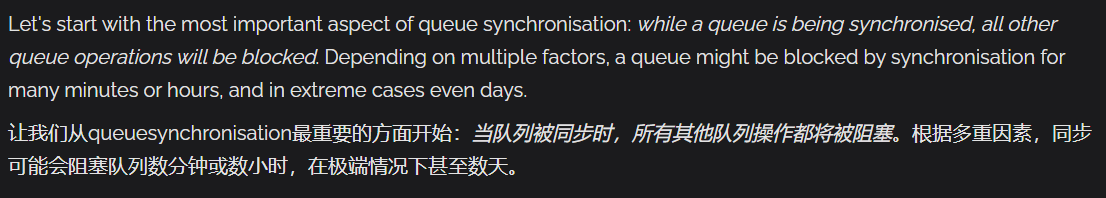
- 同步阻塞
- 当队列进行同步操作时,队列上的其他行为都将被阻塞
除了上面这些,还有几点
- rabbitmq 创建镜像策略的时候不会对宕机节点上已经存在的队列生效,宕机节点重新上线后也不会生效
- rabbitmq 镜像的节点关系可以对换,如果主节点掉线,镜像节点会升级为主节点,如果前主节点重新上线,将会成为镜像节点
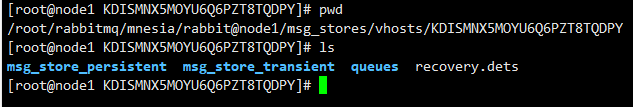
从上面两图可以看出,之前没有队列的节点,也存在队列了
仲裁队列
在镜像队列最新官方文档最上方提到了镜像队列已被弃用,被仲裁队列所代替。
RabbitMQ 的仲裁队列(Quorum Queue)是自版本 3.8.0 引入的一种高可用性队列类型,它作为镜像队列(Mirrored Queue)的替代方案,提供了改进的数据复制和恢复能力。仲裁队列的设计目标是减少故障转移时间,使用Raft协议提升队列的高可用性和数据的安全性。
创建
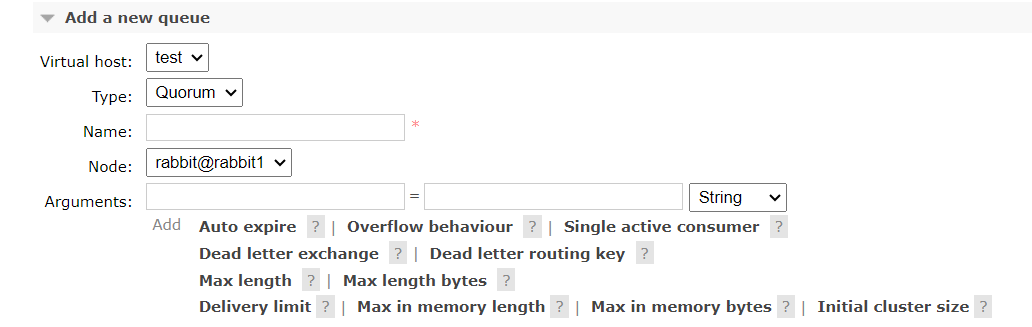
创建仲裁队列只需在创建队列时,选择type为quorum即可
如果是Spring RabbitMQ,则通过设置参数”x-queue-type”即可
1 |
|
特点
镜像队列很多特点与镜像队列一致,比如主从架构、高可用性、数据冗余和一致性等,但是解决了镜像队列很多问题,比如上面提到的宕机清空、一致确认、同步阻塞等,并且提供了一些新的特性
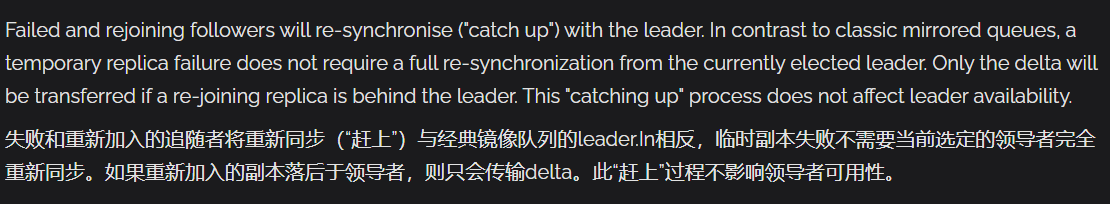
- 宕机不清空
- 基于raft算法的特性,仲裁队列不需要考虑网络分区等意外情况,所以它不需要像镜像队列一样在节点上线时清空数据,而只需要根据主节点的信息,在原来信息的基础上,同步增量的信息即可。不过新加入集群的节点需要像镜像队列一样同步
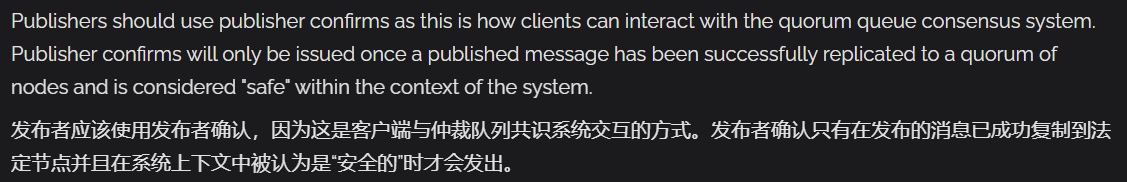
- 一致确认简化
- 基于raft算法的特性,仲裁队列的生产者确认机制不再需要应用到所有节点上在返回个生产者,只需要应用于法定节点(根据raft算法,一般是节点的一半(向上取整)),就可以返回给生产者
- 同步不阻塞
- 仲裁队列优化了镜像队列同步阻塞的问题,节点下线重新上线后的同步不会阻塞节点

- 仲裁队列优化了镜像队列同步阻塞的问题,节点下线重新上线后的同步不会阻塞节点
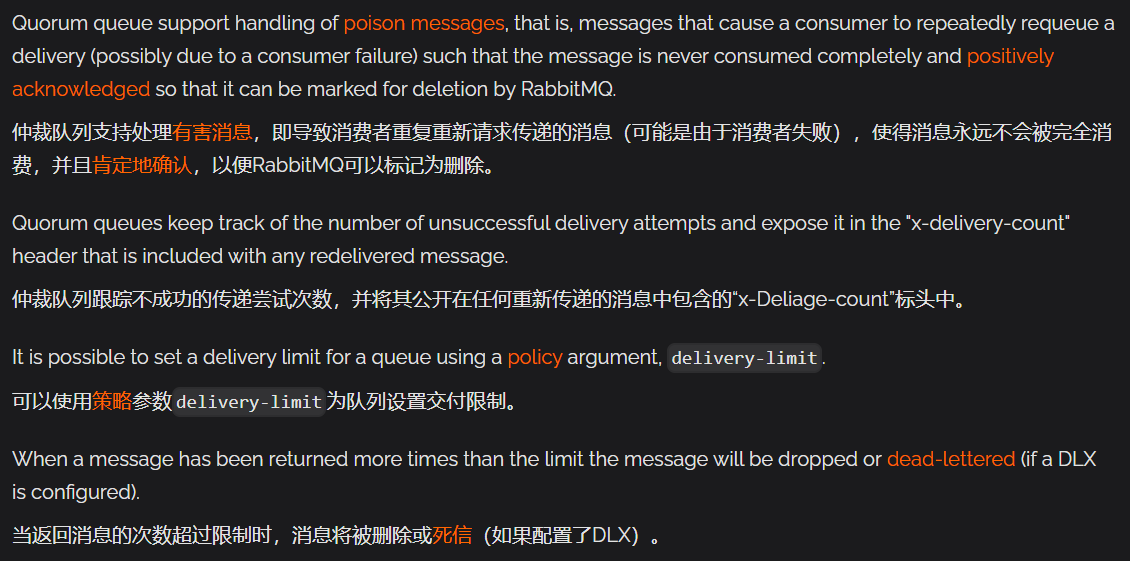
- 有害消息处理
- 对于多次消费者消费失败的消息,仲裁队列会识别出来,消息将被删除或死信(如果配置了死信交换机),这种机制类似于rocketmq
- 严格磁盘保存
- 仲裁队列在执行任何操作之前将所有数据保存到磁盘
- 存活节点数量要求
- 由于raft算法的要求,仲裁队列存活的节点数量必须达到raft算法法定数量才能使用,否则不可用,如果无法恢复到raft算法法定数量,则改仲裁队列永久不可用
- 一致性问题
- 因为仲裁队列的发布确认模式,只需要应用于法定数量就可以返回,所以写操作并非强一致性的,而是通过raft算法中的一些其他约定来保证一致性
但是仲裁队列主节点选举时是不可用的,这一操作是强一致性的,并且由于raft算法的特性,主节点选举往往需要一定的时间
- 因为仲裁队列的发布确认模式,只需要应用于法定数量就可以返回,所以写操作并非强一致性的,而是通过raft算法中的一些其他约定来保证一致性